4,2 secondes : c’est le temps mesuré pour générer un bloc de liste d’articles similaires, affiché en pied de chaque article d’un site de presse dont l’archive dépassait 500 000 contenus publiés. Ce délai, invisible sur un site à quelques milliers d’articles, devenait un goulot d’étranglement majeur à cette échelle, ralentissant chaque page du site au point de dégrader nettement les indicateurs Core Web Vitals suivis par l’équipe technique.
Le bloc en cause est une variante personnalisée de Query Loop, construite sur mesure pour intégrer une logique métier propre au site (exclusion de certaines rubriques, pondération éditoriale), ce qui excluait de simplement réutiliser le bloc Query Loop natif tel quel.
Premier suspect : le comptage total des résultats
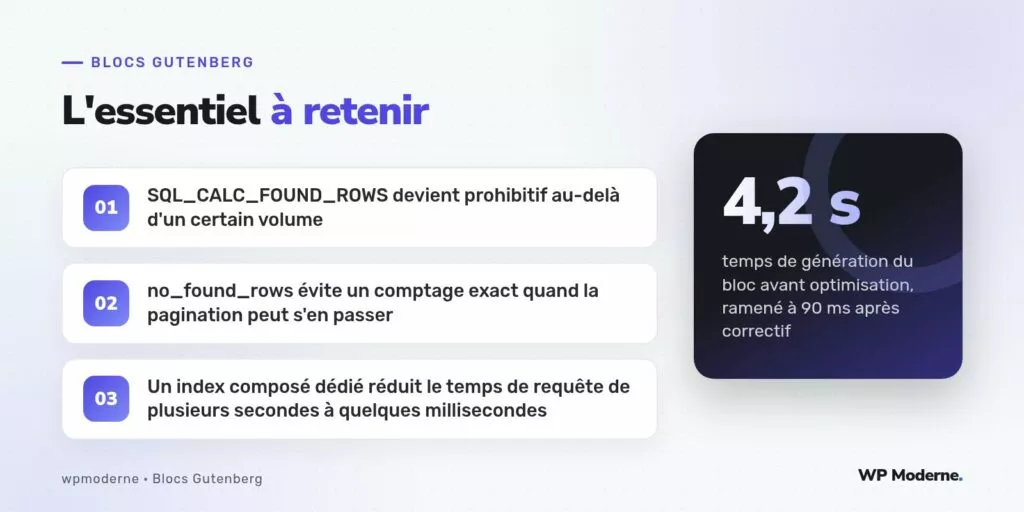
Le profilage avec Query Monitor a immédiatement pointé une requête SQL unique responsable de plus de 90 % du temps de génération du bloc : celle générée automatiquement par WP_Query pour calculer le nombre total de résultats correspondant aux critères, via SQL_CALC_FOUND_ROWS. Sur une table de cette taille, avec des critères de filtrage complexes (taxonomies multiples, exclusions), ce calcul de comptage exact devenait disproportionnellement coûteux par rapport au résultat réellement affiché — une simple liste de six articles similaires.
Désactiver le comptage quand il n’est pas nécessaire
Le bloc n’affichant jamais de pagination numérotée (seulement un lien « voir plus »), le nombre total exact de résultats correspondants n’avait strictement aucune utilité fonctionnelle. Le paramètre no_found_rows de WP_Query, souvent ignoré car peu documenté en dehors des cas de forte volumétrie, supprime ce calcul :
$query = new WP_Query( [
    'post_type'      => 'post',
    'posts_per_page' => 6,
    'no_found_rows'  => true,
    'category__in'   => $categories_similaires,
    'post__not_in'   => [ get_the_ID() ],
    'orderby'        => 'date',
    'order'          => 'DESC',
] );
Ce seul changement a fait chuter le temps de génération de 4,2 secondes à environ 600 millisecondes, un gain déjà considérable pour une seule ligne de configuration modifiée.
Deuxième optimisation : un index composé dédié
Les 600 millisecondes restantes provenaient d’un plan d’exécution SQL qui ne s’appuyait sur aucun index adapté à la combinaison exacte des critères utilisés (statut de publication, type de contenu, date, catégorie). Une analyse avec EXPLAIN sur la requête générée a confirmé un balayage complet d’une portion significative de la table wp_posts jointe à wp_term_relationships. Un index composé dédié, créé directement sur la table wp_posts, a résolu ce point :
CREATE INDEX idx_acme_similaires
ON wp_posts (post_type, post_status, post_date DESC);
Combiné à l’index déjà natif sur wp_term_relationships, ce nouvel index a permis à MySQL de choisir un plan d’exécution nettement plus efficace, ramenant le temps de génération du bloc à environ 90 millisecondes, mesuré en moyenne sur une semaine de trafic réel après déploiement.
Troisième niveau : mettre en cache le résultat final
Même à 90 millisecondes, générer cette liste à chaque affichage d’article reste un coût cumulé non négligeable à l’échelle du trafic du site. Le résultat de la requête est désormais mis en cache via l’object cache (Redis), avec une clé incluant l’identifiant de l’article courant et une durée de vie de trente minutes, largement suffisante compte tenu du rythme de publication du site :
- Clé de cache construite à partir de l’identifiant de l’article et non d’un identifiant utilisateur, cette liste ne dépendant pas du visiteur.
- Invalidation explicite du cache lors de la publication d’un nouvel article dans les mêmes catégories, via un hook
save_postciblé plutôt qu’une attente passive de l’expiration. - Suivi du taux de succès du cache (hit ratio) sur le tableau de bord de supervision, pour détecter rapidement une régression future.
| Étape | Temps de génération |
|---|---|
| Avant optimisation | 4,2 s |
Après no_found_rows | ≈ 600 ms |
| Après index composé dédié | ≈ 90 ms |
| Après mise en cache du résultat | < 5 ms (cache actif) |
Sur un très gros volume de contenus, je commence toujours par chercher où
WP_Querycalcule quelque chose dont personne n’a réellement besoin en aval : le comptage exact de résultats est le premier suspect, bien avant d’envisager une réécriture SQL complète.
En résumé
Aucune de ces trois optimisations n’a nécessité de sortir de l’API WP_Query standard ni de réécrire une requête SQL manuelle complexe. La combinaison d’un paramètre de requête souvent négligé, d’un index dédié et d’une mise en cache ciblée a suffi à diviser par plus de quarante le temps de génération de ce bloc, sur un volume de contenus qui aurait pu laisser croire qu’une refonte architecturale complète était inévitable.