18 432 : c’est le nombre de combinaisons de filtres distinctes observées en un mois sur un catalogue de taille moyenne, comptant une douzaine d’attributs filtrables. Sur un très grand catalogue, ce chiffre grimpe rapidement à plusieurs centaines de milliers de combinaisons théoriques, même si une poignée d’entre elles concentre l’essentiel du trafic réel.
Un filtre à facettes correctement pensé ne cherche donc pas à répondre vite à toutes les combinaisons possibles, mais à répondre très vite aux combinaisons réellement demandées, tout en restant correct — quoique plus lent — sur les combinaisons rares.
Pourquoi la requête directe ne suffit plus au-delà d’un certain volume
Un filtre à facettes construit naïvement au-dessus de WP_Query combine des clauses tax_query et parfois meta_query pour chaque attribut sélectionné, puis recalcule à chaque affichage le nombre de résultats disponibles pour chaque valeur restante des autres facettes — c’est ce second calcul, souvent oublié dans les estimations de charge, qui coûte le plus cher, car il nécessite une requête d’agrégation par facette non encore sélectionnée.
Sur un catalogue de plusieurs dizaines de milliers de produits, ces requêtes d’agrégation, multipliées par le nombre d’attributs, peuvent représenter la majorité du temps de génération d’une page de résultats filtrés.
Le principe de l’architecture proposée
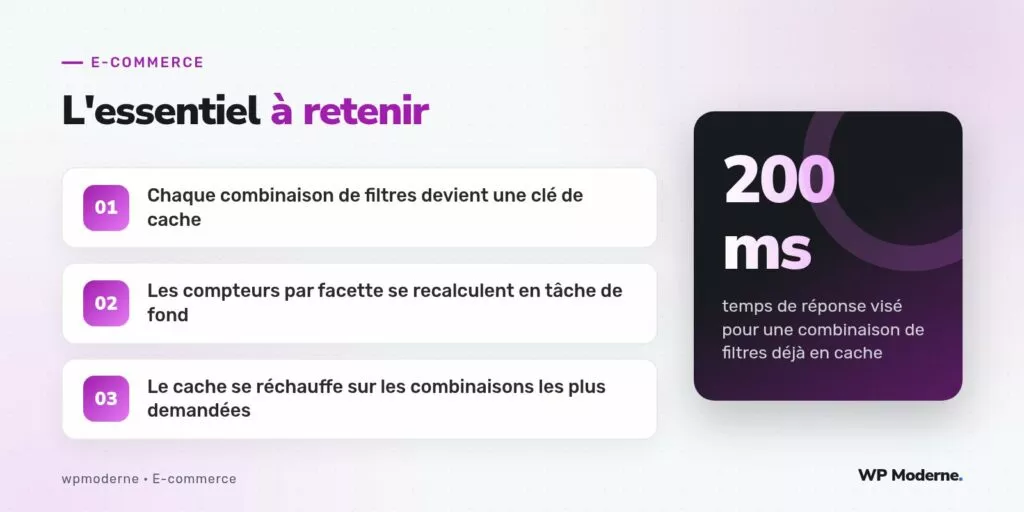
L’idée centrale consiste à traiter chaque combinaison de filtres comme une clé de cache à part entière, associée à deux éléments distincts : la liste des identifiants de produits correspondants, et les compteurs par facette restante. Ces deux éléments n’ont pas la même durée de vie utile ni le même coût de recalcul, ce qui justifie de les séparer plutôt que de tout mélanger dans une seule valeur cachée.
Arborescence de l’architecture
cache-facettes/
├── resolveur/
│   ├── normalise-combinaison.php   # trie et normalise les paramètres de filtre reçus
│   └── generateur-cle.php          # transforme une combinaison normalisée en clé stable
├── stockage/
│   ├── resultats/                  # liste d'identifiants produits par clé (objet cache)
│   └── compteurs/                  # compteurs par facette restante, par clé
├── rechauffeur/
│   ├── file-combinaisons-frequentes.php
│   └── tache-planifiee-rechauffage.php  # Action Scheduler, hors heures de pointe
└── invalidation/
    ├── ecouteur-changement-stock.php
    └── ecouteur-changement-prix.php
Le résolveur normalise d’abord la combinaison reçue — tri des valeurs par attribut, suppression des doublons, format canonique — avant de générer la clé de cache. Cette normalisation évite qu’une même combinaison exprimée dans un ordre différent dans l’URL ne génère deux entrées de cache distinctes pour un résultat identique.
Le réchauffage plutôt que l’attente de la première requête
Plutôt que de laisser chaque combinaison se mettre en cache uniquement au fil des visites, une tâche planifiée via Action Scheduler reconstruit à intervalle régulier le cache des combinaisons les plus fréquentes, identifiées à partir des journaux de requêtes des jours précédents. Ce réchauffage se déroule en dehors des heures de pointe, ce qui évite que la reconstruction du cache n’entre en concurrence avec le trafic réel pour les ressources serveur.
- Les combinaisons à une ou deux facettes, statistiquement les plus consultées, sont réchauffées en priorité.
- Les combinaisons à quatre facettes ou plus restent calculées à la demande, avec une durée de cache plus courte.
- Un compteur d’accès par clé permet de faire évoluer dynamiquement la liste des combinaisons à réchauffer.
Invalidation : le point le plus délicat
Un changement de stock ou de prix sur un seul produit peut invalider un grand nombre de combinaisons de facettes en une seule opération. Invalider tout le cache à chaque modification annule l’intérêt de l’architecture ; invalider trop peu conduit à afficher des compteurs erronés. La solution retenue associe à chaque produit la liste des combinaisons de facettes dans lesquelles il apparaît, construite au moment de l’indexation, pour ne cibler que les entrées réellement concernées lors d’une mise à jour.
Notre verdict
Cette architecture demande un investissement initial réel — normalisation des clés, séparation résultats et compteurs, invalidation ciblée — qui ne se justifie pas sur un catalogue de quelques centaines de références. Elle devient en revanche difficile à éviter au-delà d’un certain volume, quand le coût des requêtes d’agrégation dépasse largement celui d’une couche de cache dédiée.