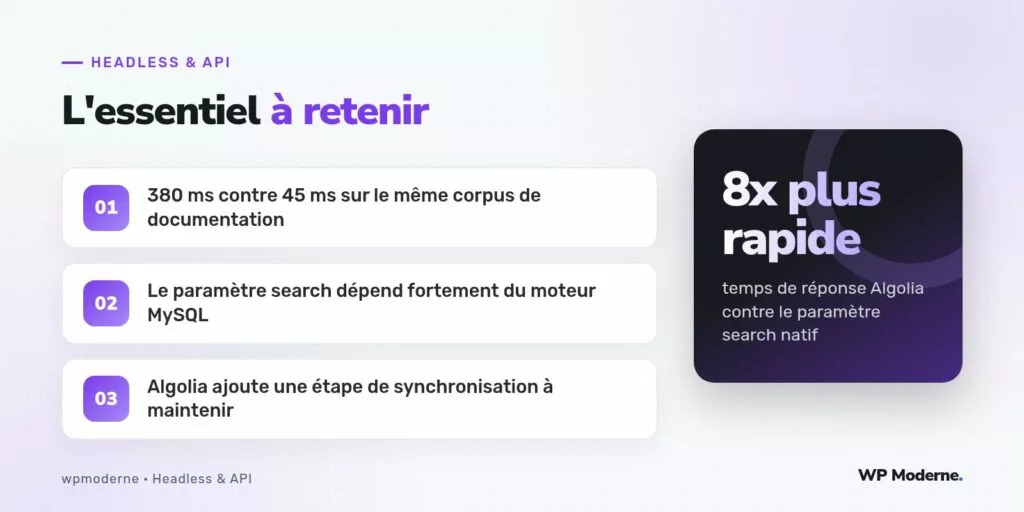
380 millisecondes en moyenne, pointes à 1,2 seconde sous charge : c’est le temps de réponse mesuré sur l’endpoint /wp-json/wp/v2/search d’un site de documentation technique de 4 000 pages, interrogé avec le paramètre search. Le même jeu de requêtes, exécuté sur un index Algolia synchronisé quotidiennement, répond en 45 millisecondes en moyenne. Le rapport ne surprend personne qui connaît les deux outils, mais il mérite d’être chiffré avant de choisir une architecture.
Ce comparatif porte uniquement sur la latence perçue par un front headless consommant l’un ou l’autre. Il ne traite pas du budget Algolia, ni de la complexité d’intégration d’un plan payant à partir d’un certain volume de recherches — c’est un autre arbitrage, avec d’autres chiffres.
Le protocole de mesure
Le corpus retenu est un site de documentation réel, exporté avec son contenu Gutenberg complet : 4 000 articles, dont environ 60 % dépassent 1 500 mots. Cinquante requêtes représentatives ont été rejouées cent fois chacune, à froid puis à chaud, contre les deux systèmes, depuis un même front Next.js hébergé sur Vercel.
Le endpoint natif wp/v2/search a été interrogé tel quel, sans plugin d’accélération de recherche, sur une base MySQL 5.7 hébergée sur un serveur mutualisé équivalent à ce que beaucoup de projets utilisent en production pour un site de cette taille.
Ce que révèlent les chiffres
Le tableau suivant résume les résultats agrégés sur l’ensemble des cinquante requêtes :
| Indicateur | API REST native | Algolia |
|---|---|---|
| Temps de réponse moyen | 380 ms | 45 ms |
| Temps de réponse au 95e centile | 920 ms | 78 ms |
| Pertinence perçue (test utilisateur, 20 personnes) | Correcte sur mots exacts | Bonne même avec fautes de frappe |
| Recherche floue / typo-tolerance | Absente | Native |
| Facettes et filtres combinés | À coder soi-même | Natifs |
Pourquoi un tel écart
Le paramètre search de l’API REST délègue la requête à WP_Query, qui construit une clause SQL avec des LIKE '%terme%' sur les colonnes post_title, post_excerpt et post_content. Sur une table volumineuse, ce type de clause ne peut pas s’appuyer sur un index classique : MySQL doit parcourir une part significative de la table à chaque recherche. Plus le corpus grossit, plus la latence grimpe, de façon à peu près linéaire dans les tests menés ici.
Algolia, à l’inverse, repose sur un index inversé optimisé pour la recherche texte, hébergé sur une infrastructure dédiée à cet usage. La contrepartie est la synchronisation : chaque publication ou mise à jour de contenu doit déclencher un envoi vers l’index, via l’API d’Algolia ou un plugin qui l’encapsule, sous peine de désynchronisation entre WordPress et les résultats affichés.
Une piste intermédiaire
Avant de basculer sur un service tiers, certains projets ajoutent un index MySQL FULLTEXT sur les colonnes recherchées, ou remplacent le paramètre search par une requête personnalisée exploitant cet index. Les gains observés sur ce même corpus tournent autour de 40 %, loin derrière Algolia mais sans dépendance externe ni synchronisation à maintenir.
Le verdict
Pour un site de documentation où la recherche est un point d’entrée central de la navigation, l’écart de performance et de pertinence justifie largement l’ajout d’Algolia, malgré la complexité de synchronisation supplémentaire. Pour un site vitrine où la recherche reste une fonctionnalité secondaire, consultée occasionnellement, l’endpoint natif reste largement suffisant, surtout combiné à un index FULLTEXT.
- Corpus de plus de 1 000 contenus avec recherche fréquente : Algolia se justifie.
- Corpus modeste, recherche occasionnelle : l’API REST native suffit.
- Besoin de typo-tolerance ou de facettes combinées : Algolia reste la seule option pratique.
Un moteur de recherche externe n’est jamais gratuit, même quand son plan tarifaire l’est encore : il ajoute un système à synchroniser, à surveiller, et un point de défaillance supplémentaire dans l’architecture.
Pour aller plus loin
Ce comparatif ne tranche pas la question du coût d’Algolia au-delà d’un certain volume de recherches mensuelles, ni les stratégies de synchronisation incrémentale à mettre en place pour éviter de réindexer l’intégralité du corpus à chaque publication. Ce sont deux sujets à traiter séparément, une fois le choix du moteur arrêté sur la base de la performance et de la pertinence attendues.



