Trois secondes de chargement perçues par les utilisateurs, deux équipes convaincues chacune que le problème vient de l’autre : l’équipe front, persuadée que l’API WordPress répond trop lentement, et l’équipe back-end, certaine que le rendu React consomme l’essentiel du temps. Sans données pour trancher, ce type de désaccord peut s’éterniser des semaines sur un projet headless.
La résolution est venue d’un traçage distribué mis en place avec Sentry Performance, reliant les transactions du frontend Next.js à celles de l’API REST WordPress via un identifiant de trace propagé d’un système à l’autre. Le verdict, une fois les données disponibles, a surpris les deux équipes : le temps de réponse de l’API WordPress ne représentait qu’une fraction modeste du temps total perçu.
Sans traçage distribué, un diagnostic à l’aveugle
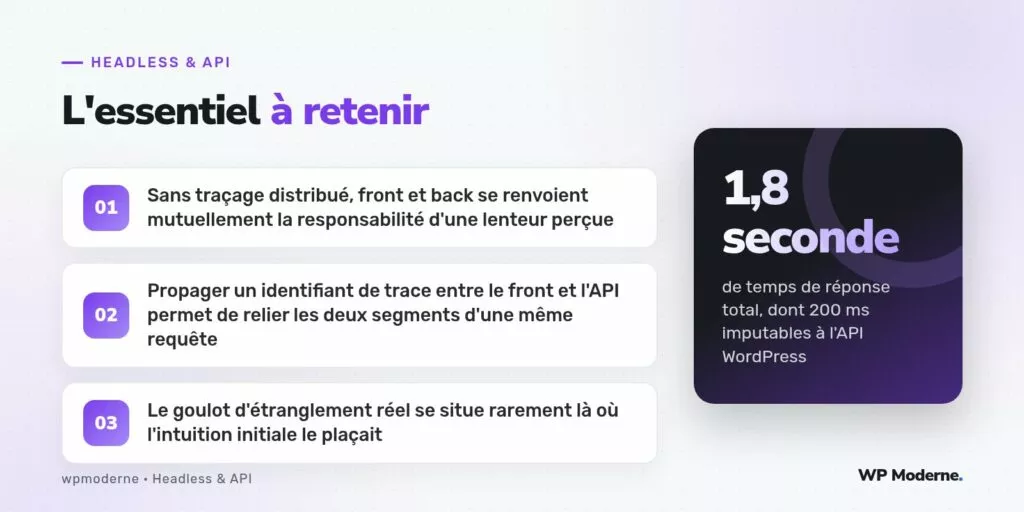
Chaque système disposait déjà de sa propre instrumentation Sentry, mais de façon cloisonnée : les transactions front montraient un temps de chargement de page d’environ 1,8 seconde, sans détail sur la répartition entre l’appel réseau vers l’API, le temps de traitement JavaScript et le rendu du DOM. Côté WordPress, les transactions API affichaient des temps de réponse propres, mais sans lien visible avec la transaction front correspondante.
Impossible, dans ces conditions, de savoir si les 1,8 seconde observées côté front correspondaient à un appel API de 1,5 seconde suivi d’un rendu rapide, ou l’inverse.
Propager l’identifiant de trace entre front et API
Sentry propose un mécanisme de propagation de trace via l’en-tête sentry-trace, transmis automatiquement par le SDK JavaScript côté front lors de chaque appel réseau, à condition que le domaine de destination soit explicitement autorisé :
// next.config.js / sentry.client.config.js
Sentry.init({
  dsn: process.env.SENTRY_DSN_FRONT,
  tracePropagationTargets: ['https://cms.monsite.fr/wp-json'],
  tracesSampleRate: 0.2,
});
Côté WordPress, le SDK Sentry PHP doit être configuré pour reconnaître et poursuivre cette trace entrante plutôt que d’en démarrer une nouvelle, en lisant l’en-tête sentry-trace reçu :
add_action('rest_api_init', function () {
    $trace_entrante = $_SERVER['HTTP_SENTRY_TRACE'] ?? null;

    if ($trace_entrante) {
        $contexte = \Sentry\Tracing\TransactionContext::fromHeaders($trace_entrante, '');
        $transaction = \Sentry\startTransaction($contexte);
        \Sentry\SentrySdk::getCurrentHub()->setSpan($transaction);
    }
}, 1);
Ce que la trace complète a révélé
Une fois le lien établi entre les deux systèmes, le tableau de vue en cascade (waterfall) de Sentry a montré la répartition réelle des 1,8 seconde de temps de chargement :
| Segment | Durée | Part du total |
|---|---|---|
| Requête API WordPress | 200 ms | 11 % |
| Transfert réseau et TTFB front | 350 ms | 19 % |
| Hydratation et rendu React | 1 250 ms | 70 % |
L’API WordPress, longtemps désignée comme responsable présumé, n’expliquait qu’une part marginale du temps total. Le véritable goulot d’étranglement se situait dans l’hydratation d’un composant de galerie d’images chargeant l’intégralité de son JavaScript de façon synchrone avant le premier rendu interactif.
Corriger sans se fier à l’intuition
Sans cette donnée précise, l’équipe se serait probablement lancée dans une optimisation de requêtes SQL côté WordPress, avec un gain marginal sur le ressenti utilisateur final. Le traçage distribué a permis de rediriger l’effort vers le vrai problème : un découpage plus fin du bundle JavaScript du composant de galerie, avec un chargement différé.
- Éviter de deviner la cause d’une lenteur sans donnée de traçage reliée entre les systèmes
- Fixer un taux d’échantillonnage raisonnable (0,2 ici) pour ne pas saturer le quota Sentry
- Revoir la répartition des segments après chaque optimisation, pas seulement au départ
Ce que cet audit n’a pas couvert
Ce travail s’est concentré sur la localisation du ralentissement perçu à l’échelle d’une requête donnée. La question plus large de l’architecture globale du projet (choix du framework, stratégie de rendu SSR ou SSG) n’a volontairement pas été remise en question dans le cadre de cet audit ponctuel.
En résumé
Relier les traces Sentry du front et de l’API WordPress transforme un débat d’opinions entre équipes en une donnée factuelle et partagée. Sur ce projet, le vrai ralentissement se cachait du côté que personne ne soupçonnait initialement, ce qui à lui seul justifie l’investissement dans un traçage distribué correctement configuré.



