Douze intégrations tierces, un frontend Next.js, un WordPress en API pure : sur le papier, l’architecture headless d’un site vitrine B2B semblait d’une simplicité limpide. Dans les faits, retracer le parcours d’une seule adresse e-mail depuis le formulaire de contact jusqu’à sa suppression effective a demandé trois jours de travail et la relecture de sept dépôts de code différents.
Ce constat n’est pas propre à ce projet. Dès qu’un front découplé communique avec des services de paiement et de CRM, les flux de données personnelles cessent d’être visibles dans une seule base MySQL. Ils se dispersent entre le front, l’API WordPress, les webhooks sortants et les tableaux de bord tiers. Avant de rédiger un registre de traitements RGPD digne de ce nom, il faut d’abord savoir où regarder.
Pourquoi le headless complique la cartographie
Sur un WordPress classique avec formulaire natif, une donnée entre par un point unique et repart, au pire, vers un plugin d’emailing. Dans une architecture découplée, le même formulaire est souvent un composant React qui poste directement vers un endpoint REST personnalisé, lequel relaie ensuite l’information vers HubSpot via son API, pendant qu’un paiement Stripe déclenche en parallèle un webhook qui met à jour un statut de commande dans WordPress.
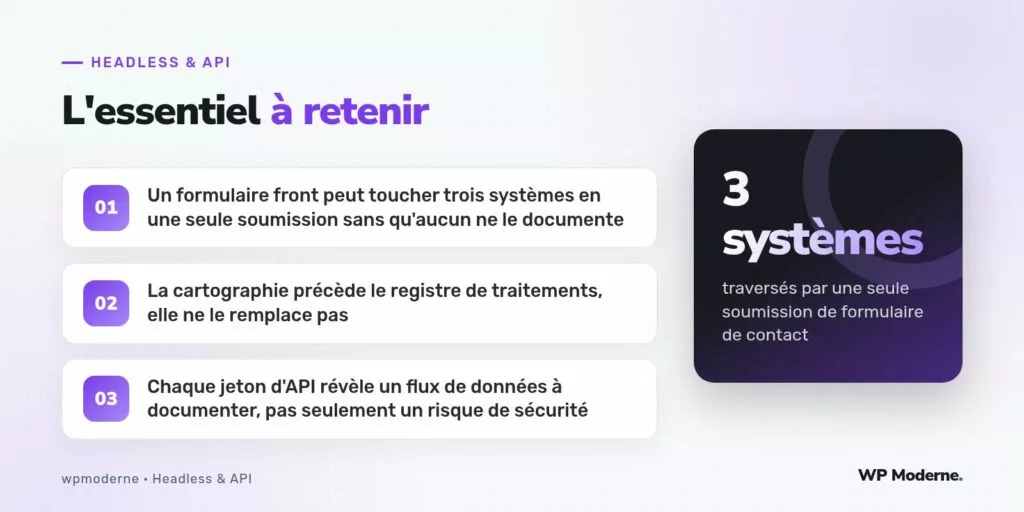
Trois systèmes traitent donc la même personne, avec des politiques de rétention différentes, des responsables de traitement potentiellement distincts et des bases légales qui ne se recoupent pas forcément. Un consentement marketing coché pour HubSpot n’autorise pas la conservation prolongée d’un numéro de carte partiellement masqué côté Stripe.
Étape 1 : lister les points d’entrée de données
La première étape consiste à énumérer, sans exception, chaque endroit où une donnée personnelle entre dans le système. Sur un projet headless, cela couvre généralement :
- Les formulaires front qui postent vers
register_rest_routeou vers un service tiers directement - Les webhooks entrants de Stripe (paiement, remboursement, litige)
- Les synchronisations sortantes vers HubSpot (création de contact, mise à jour de propriété)
- Les cookies de session ou jetons stockés côté navigateur
Chaque ligne de cette liste correspond à un flux qu’il faudra documenter avec sa finalité, sa base légale et sa durée de conservation. Un tableur partagé avec l’équipe technique suffit largement à ce stade ; l’outillage sophistiqué peut attendre.
Étape 2 : suivre la donnée jusqu’à sa destination finale
Une fois les points d’entrée listés, il faut remonter chaque flux jusqu’à son point de repos. Un e-mail saisi dans un formulaire de contact peut ainsi finir stocké à quatre endroits différents : la table wp_posts si le formulaire crée une entrée personnalisée, les logs du serveur applicatif Next.js, le contact HubSpot correspondant, et un export CSV oublié sur un poste de travail après un import manuel.
Ce dernier cas, plus fréquent qu’on ne le pense, échappe systématiquement à un audit purement technique. Interroger les équipes marketing sur leurs habitudes d’export fait partie intégrante de la cartographie.
Étape 3 : croiser les durées de rétention
| Système | Donnée typique | Durée observée |
|---|---|---|
| WordPress (API REST) | Contenu du formulaire | Illimitée par défaut |
| Stripe | Historique de paiement | 10 ans (obligations comptables) |
| HubSpot | Contact marketing | Variable selon le workflow de purge |
Ce tableau, une fois rempli pour un projet réel, révèle presque toujours une incohérence : WordPress conserve par défaut indéfiniment ce que les deux autres systèmes purgent ou anonymisent après une période définie. C’est souvent là que se cache le point de non-conformité le plus simple à corriger.
Étape 4 : documenter les jetons et leurs portées
Un audit RGPD headless n’est pas qu’une affaire de finalités et de durées : chaque jeton d’API utilisé pour relier les systèmes doit être recensé avec la portée de données qu’il autorise. Un jeton HubSpot avec un scope contacts.write illimité, partagé entre trois applications différentes, complique furieusement toute réponse à une demande de droit d’accès.
Un jeton d’API sans scope documenté est une porte dont on a perdu le plan de la maison.
En résumé
Cartographier les flux de données d’un site headless avant de rédiger un registre de traitements n’est pas une formalité : c’est souvent le moment où l’on découvre qu’une intégration oubliée conserve des données bien au-delà de ce que prévoit la politique de confidentialité publiée. Cette checklist ne remplace pas le registre lui-même, mais elle en constitue le squelette indispensable, et elle évite de le rédiger à l’aveugle en se fiant uniquement à la documentation marketing des outils tiers.



