Un espace client et un site vitrine ne devraient jamais partager le même point d’entrée d’API, et c’est précisément l’erreur qu’une étude notariale a failli commettre en construisant son nouveau site public. Le contenu éditorial du site vitrine — actualités du cabinet, présentation des notaires, articles d’information juridique — devait rester accessible publiquement via l’API REST, tandis que l’espace client, hébergé sur le même WordPress pour des raisons pratiques, contenait des documents sensibles rattachés à des types de contenus distincts mais visibles par la même route générique si elle n’était pas restreinte.
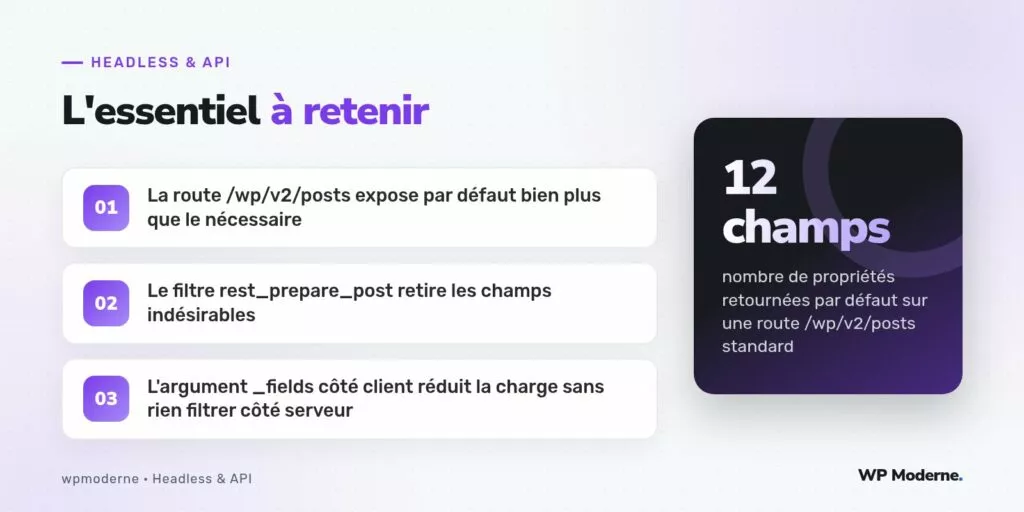
La route native /wp/v2/posts renvoie par défaut une douzaine de champs par article : contenu complet, extrait, méta liées au format, liens vers l’auteur et bien d’autres. Sur un site où certains de ces champs peuvent laisser fuiter des informations internes, ce comportement par défaut ne convient pas tel quel.
Ce que révèle un simple appel non filtré
Un appel brut à la route standard, sans aucune restriction, retourne des champs que le front vitrine n’utilisera jamais, mais qui restent techniquement accessibles à quiconque connaît l’URL de l’API.
GET /wp-json/wp/v2/posts/42

{
  "id": 42,
  "date": "2020-06-28T09:15:00",
  "guid": { "rendered": "https://etude-exemple.fr/?p=42" },
  "content": { "rendered": "..." },
  "excerpt": { "rendered": "..." },
  "author": 3,
  "meta": { "_notes_internes": "à revoir avant publication" }
}
Le champ meta ici illustre le vrai risque : une méta interne, jamais destinée à sortir du back-office, se retrouve exposée simplement parce qu’elle est enregistrée avec show_in_rest activé sur son groupe de champs, sans restriction supplémentaire.
Première protection : filtrer côté serveur avec rest_prepare_post
Le filtre rest_prepare_post permet de retirer des champs de la réponse juste avant son envoi, quelle que soit la façon dont le client a formulé sa requête. C’est la seule approche fiable pour une donnée réellement sensible, puisqu’elle ne dépend d’aucun paramètre côté client.
add_filter( 'rest_prepare_post', function( $response, $post, $request ) {
    $data = $response->get_data();
    unset( $data['guid'] );
    unset( $data['meta']['_notes_internes'] );
    $response->set_data( $data );
    return $response;
}, 10, 3 );
Deuxième levier : l’argument _fields côté client
Pour les cas où la donnée n’est pas sensible mais simplement inutile au front, l’argument de requête _fields réduit la réponse aux seules propriétés demandées, sans rien changer côté serveur.
GET /wp-json/wp/v2/posts?_fields=id,title,excerpt,linkCe mécanisme allège la réponse et le temps de sérialisation JSON, mais il ne doit jamais être confondu avec une mesure de sécurité : rien n’empêche un client d’omettre _fields et de récupérer la totalité des données non filtrées côté serveur.
Le cas particulier des révisions et des brouillons
Un point a failli échapper à l’équipe technique lors des tests : la route /wp/v2/posts ne renvoie par défaut que les articles publiés à un visiteur non authentifié, mais un paramètre de requête mal contrôlé aurait pu, dans une version antérieure du code, laisser filtrer un statut différent si l’authentification de l’espace client partageait par erreur le même jeton que le site vitrine.
Ce risque a été écarté en s’assurant que les deux espaces utilisent des mécanismes d’authentification totalement distincts, sans jamais partager de cookie de session ni de jeton entre le site vitrine public et l’espace client réservé.
Répartition des responsabilités
- Donnée sensible à ne jamais exposer : filtrage obligatoire côté serveur via
rest_prepare_post - Donnée publique mais inutile pour un affichage donné : réduction côté client via
_fields
Une donnée sensible filtrée uniquement côté client n’est jamais réellement protégée ; elle est simplement moins visible dans les cas d’usage prévus.
En résumé
Pour cette étude notariale, la séparation nette entre filtrage serveur des champs sensibles et allégement client des champs inutiles a permis de conserver un WordPress unique pour le site vitrine et l’espace client, sans jamais mélanger les deux surfaces exposées par l’API REST. Ce cas ne traite pas la question de l’authentification de l’espace client lui-même, qui mériterait un traitement séparé et plus approfondi.



