Une requête qui interroge vingt articles et l’auteur de chacun d’entre eux ne devrait, en théorie, nécessiter que deux allers-retours vers la base de données : un pour les articles, un pour l’ensemble des auteurs concernés. Dans la pratique, un schéma GraphQL naïvement résolu peut en déclencher vingt et un : un pour la liste, puis un par article pour récupérer son auteur individuellement. Ce phénomène porte un nom bien connu des développeurs qui manipulent des API à base de graphes : le problème N+1.
Sur un projet WPGraphQL exposant un contenu imbriqué — des articles avec leurs auteurs, leurs catégories et leurs champs personnalisés liés — ce défaut de conception passe souvent inaperçu tant que le volume de données reste faible. Il devient rapidement visible dès que le nombre de nœuds imbriqués augmente, avec des temps de réponse qui croissent de façon linéaire, voire pire, avec la taille de la liste demandée.
Comprendre pourquoi un résolveur naïf multiplie les requêtes
Dans l’architecture de résolution GraphQL, chaque champ d’un type peut disposer de sa propre fonction de résolution, appelée indépendamment pour chaque nœud du graphe. Un champ author défini sur le type Post sera donc invoqué une fois par article retourné dans la liste, sans qu’aucune coordination naturelle n’existe entre ces appels successifs. Chaque invocation, livrée à elle-même, va chercher son propre auteur en base, ignorant que dix-neuf autres résolveurs frères s’apprêtent à faire exactement la même chose pour d’autres identifiants.
Ce que DataLoader ne fait pas
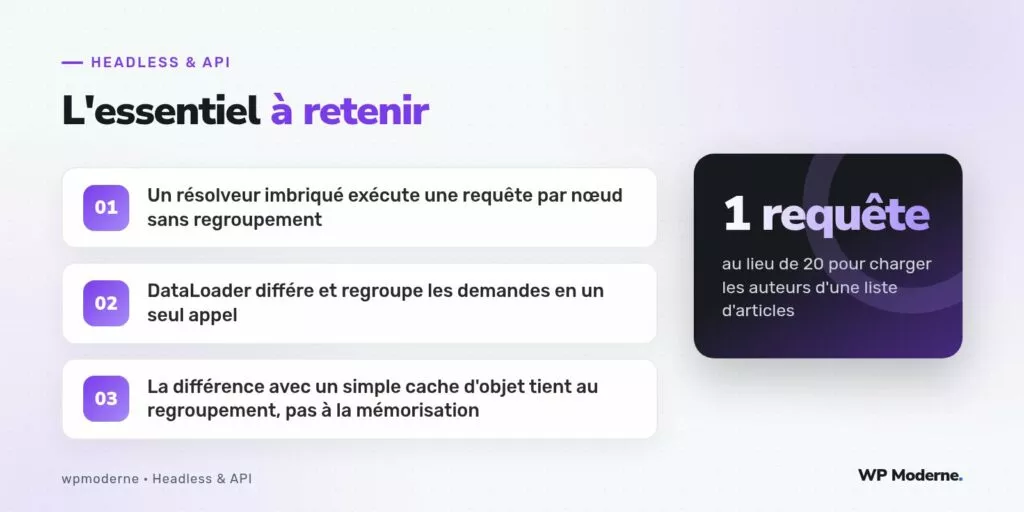
Il est tentant de confondre ce patron avec un simple cache d’objet en mémoire, du type de celui que propose déjà WordPress via wp_cache_get(). Un cache d’objet évite de recharger deux fois la même donnée au cours d’une requête, mais il ne change rien au nombre d’allers-retours vers la base si chaque identifiant demandé est différent. DataLoader agit à un autre niveau : il ne mémorise pas seulement, il regroupe.
Le mécanisme : différer puis regrouper
Le principe de DataLoader consiste à intercepter chaque demande individuelle de chargement — « donne-moi l’auteur d’identifiant 12 », « donne-moi l’auteur d’identifiant 34 » — sans l’exécuter immédiatement. Ces demandes s’accumulent dans une file d’attente le temps d’un tick de la boucle d’événements. Une fois toutes les demandes du cycle courant collectées, une seule fonction de chargement par lot (batchLoadFn) est invoquée avec l’ensemble des identifiants réunis, et se charge d’exécuter une requête unique couvrant tous les cas.
const authorLoader = new DataLoader(async (ids) => {
  const users = await wpdbFetchUsersByIds(ids);
  const map = new Map(users.map((u) => [u.id, u]));
  return ids.map((id) => map.get(id) || null);
});

// Chaque résolveur appelle simplement :
const author = await authorLoader.load(post.authorId);
Ce que voit chaque résolveur individuel ne change pas : il continue d’appeler load(id) comme s’il agissait seul. C’est la mécanique interne de DataLoader, via sa file d’attente et sa fonction de traitement par lot, qui transforme vingt appels distincts en un seul chargement groupé.
L’implémentation côté WPGraphQL
WPGraphQL, construit sur la bibliothèque graphql-php, intègre déjà ce patron pour les relations natives comme les auteurs de contenus ou les taxonomies associées. Le point d’attention se situe surtout lors de l’ajout de champs personnalisés via register_graphql_field() : un résolveur écrit sans recours à un chargeur par lot réintroduit le même défaut, même au sein d’un schéma par ailleurs bien optimisé.
Pour un champ personnalisé qui référence, par exemple, un produit lié dans une table externe, la bonne pratique consiste à créer un chargeur dédié, enregistré dans le contexte de la requête, plutôt que d’exécuter une requête directe à chaque invocation du résolveur.
Ce que ce patron ne résout pas
DataLoader répond au problème du nombre de requêtes, mais ne dit rien de la profondeur autorisée d’une requête GraphQL ni de la pagination des listes imbriquées. Un client qui demande les commentaires de chaque article, puis les auteurs de chaque commentaire, puis leurs avatars, continue de construire un graphe potentiellement coûteux à résoudre même une fois chaque niveau optimisé individuellement.
- La limitation de la profondeur de requête reste une protection complémentaire, distincte du regroupement de charge.
- La mise en cache au niveau de la réponse HTTP complète reste utile en complément, pour les requêtes identiques répétées.
- Le regroupement par lot n’élimine pas le besoin de réfléchir à la complexité globale d’un schéma exposé publiquement.
Un schéma GraphQL correctement pensé ne se juge pas sur sa capacité à répondre à une requête isolée, mais sur son comportement quand cette même requête est répétée cent fois avec des listes de taille réaliste.
Notre verdict
Le patron DataLoader mérite d’être compris avant d’être invoqué comme solution automatique : sa valeur réside précisément dans le regroupement des appels différés, pas dans une simple mémorisation. Sur tout schéma WPGraphQL étendu par des champs personnalisés, vérifier que chaque résolveur imbriqué s’appuie sur un chargeur par lot, plutôt que sur une requête directe, évite une dégradation de performance qui ne se manifeste souvent qu’une fois le contenu réel en place.



