Combien de fois une même antenne locale peut-elle apparaître dans les résultats de recherche d’un annuaire national ? Sur le nouveau site headless d’une association fédérant plusieurs centaines de structures locales, la réponse initiale était : jusqu’à deux fois, selon que la fiche avait été importée depuis WordPress ou synchronisée depuis un tableur régional maintenu en parallèle par les antennes elles-mêmes.
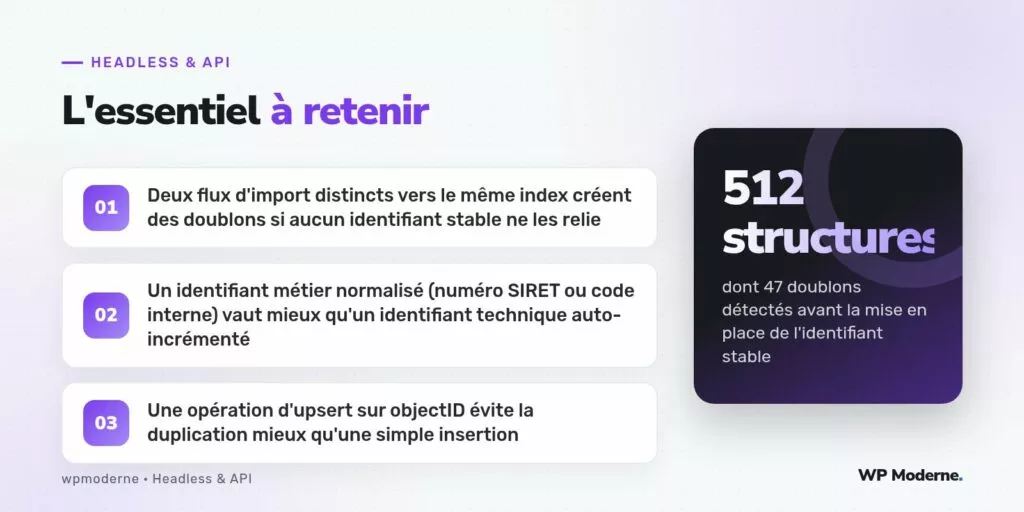
Le site consommait un index Algolia alimenté par deux sources distinctes : un flux automatique depuis le WordPress national, et un import manuel périodique depuis les fichiers transmis par certaines fédérations régionales encore en transition vers le nouveau système. Sans mécanisme de rapprochement entre ces deux flux, 47 structures sur 512 se retrouvaient dupliquées dans les résultats de recherche.
Le piège : deux identifiants pour une même entité
Le flux WordPress attribuait à chaque fiche un objectID Algolia basé sur l’identifiant de l’article (post_id). L’import régional, lui, générait un identifiant séquentiel propre à son propre script, sans rapport avec celui de WordPress. Une structure présente dans les deux sources recevait donc deux identifiants totalement différents, et Algolia les traitait comme deux enregistrements distincts plutôt que comme une mise à jour du même enregistrement.
La solution la plus robuste ne consistait pas à renforcer la coordination entre les deux équipes d’import, mais à faire reposer la déduplication sur une donnée métier stable, indépendante du système technique d’origine : le numéro SIRET de chaque structure locale, unique par construction.
Reconstruire l’objectID à partir d’un identifiant métier
function genererObjectId($structure) {
    $siret = preg_replace('/\s+/', '', $structure['siret']);
    return 'structure_' . $siret;
}

$enregistrement = [
    'objectID' => genererObjectId($structure),
    'nom' => $structure['nom'],
    'ville' => $structure['ville'],
    'source' => $structure['origine'], // 'wordpress' ou 'import_regional'
];

$index->saveObject($enregistrement); // upsert natif Algolia sur objectID
La méthode saveObject d’Algolia effectue nativement une opération d’upsert : si un enregistrement porte un objectID déjà présent dans l’index, il est mis à jour plutôt que dupliqué. En reconstruisant systématiquement le même identifiant à partir du numéro SIRET, quel que soit le flux d’origine, les deux sources convergent désormais vers un seul et même enregistrement.
Gérer les conflits entre les deux sources
Restait à trancher un cas plus délicat : que faire quand WordPress et l’import régional contiennent des informations différentes pour la même structure (une adresse mise à jour d’un côté, un numéro de téléphone plus récent de l’autre) ? La règle retenue attribue une priorité par champ plutôt qu’une priorité globale par source :
- Les champs de contenu éditorial (description, horaires) proviennent toujours de WordPress, considéré comme la source de vérité éditoriale
- Les champs de coordonnées (adresse, téléphone) proviennent de l’import régional, plus à jour sur ce périmètre
- Un champ
derniere_maj_sourcehorodate chaque origine pour permettre un audit a posteriori
Détecter les doublons résiduels
Un script de contrôle, exécuté après chaque synchronisation complète, interroge l’index Algolia et regroupe les enregistrements par nom normalisé et code postal, signalant tout groupe de plus d’un enregistrement ne partageant pas le même objectID reconstruit. Cette vérification a permis de repérer, dans un second temps, des structures ayant changé de SIRET suite à une fusion administrative, cas que la logique initiale ne couvrait pas.
Ce que cette correction ne traite pas
Cette intervention portait exclusivement sur l’élimination des doublons dans l’index. Les questions de performance de recherche (temps de réponse, pertinence du classement des résultats) ont fait l’objet d’un travail séparé, non abordé ici.
Pour aller plus loin
Face à plusieurs sources alimentant un même index de recherche, la tentation est grande de renforcer la coordination humaine entre les équipes responsables de chaque flux. Un identifiant métier stable, reconstruit de façon déterministe quelle que soit la source, règle le problème une fois pour toutes et rend la synchronisation résiliente même quand une des deux équipes change de méthode d’import sans prévenir l’autre.



