En 2008, Blogger imposait encore ses URLs sous la forme /2008/03/titre-du-billet.html, une structure figée que son propriétaire avait fini par accepter faute d’alternative simple à l’époque. Douze ans plus tard, ce blog personnel devenu une référence dans sa niche a migré vers un WordPress consommé en headless par un front Gatsby, avec une contrainte non négociable : ne perdre aucun des liens qui pointaient vers ce blog depuis des centaines de sites tiers.
Ce retour d’expérience détaille la mécanique de préservation des URLs, pas l’aspect éditorial de la migration. Le contenu lui-même — plus de deux cents billets — avait déjà été exporté au format Atom via l’export natif de Blogger, puis transformé en articles WordPress par un script d’import ponctuel.
Comprendre la structure d’URL héritée
Blogger génère ses permaliens à partir de la date de publication et d’un identifiant dérivé du titre, sans jamais exposer de rubrique ni de catégorie dans le chemin. Un article de mars 2008 se retrouve donc sous /2008/03/titre-du-billet.html, quelle que soit sa thématique.
WordPress, de son côté, structure ses permaliens différemment par défaut, et l’API REST expose les articles via leur identifiant ou leur slug, sans reproduire nativement cette arborescence par année et mois suivie du suffixe .html.
Construire le tableau de correspondance avant tout import
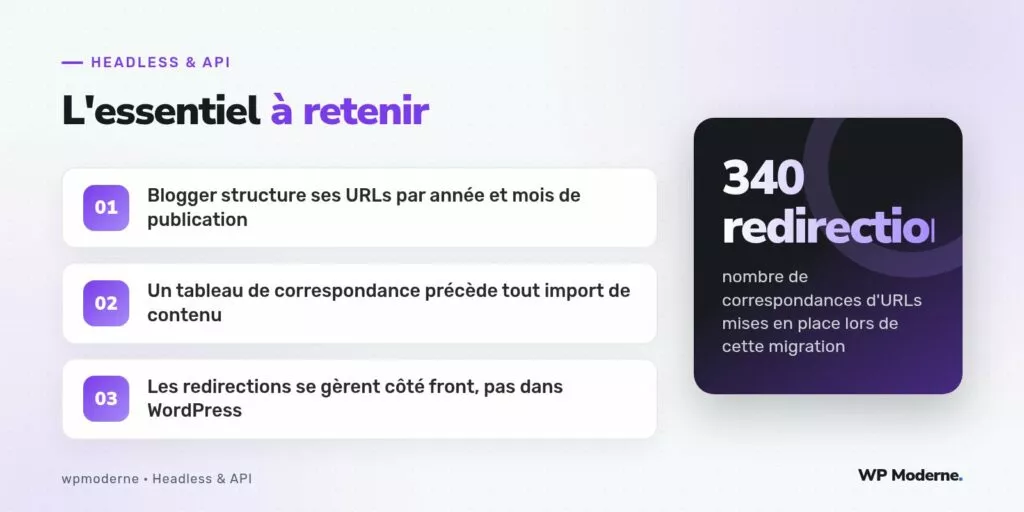
La première étape, bien avant d’écrire la moindre ligne de code d’import, a consisté à extraire l’intégralité des URLs Blogger existantes à partir du fichier d’export Atom, puis à les associer à un slug WordPress cible encore inexistant à ce stade.
{
  "ancienne_url": "/2008/03/titre-du-billet.html",
  "nouveau_slug": "titre-du-billet",
  "date_origine": "2008-03-14"
}
Ce tableau, stocké dans une table personnalisée plutôt que dans les métadonnées natives, a servi de source unique de vérité pour générer ensuite les règles de redirection, indépendamment de l’ordre dans lequel les articles seraient réellement importés.
Exposer la correspondance via une route REST dédiée
Plutôt que de gérer les redirections dans WordPress lui-même, ce qui aurait nécessité de maintenir un thème actif juste pour cette fonction, la correspondance a été exposée par une route REST simple, interrogée par le front Gatsby au moment du build.
register_rest_route( 'migration/v1', '/redirections', array(
    'methods'             => 'GET',
    'callback'            => 'migration_get_redirections',
    'permission_callback' => '__return_true',
) );
Le front Gatsby, lors de sa génération statique, consomme cette route une seule fois et génère un fichier de redirections consommé ensuite par l’hébergeur du site statique, sans jamais solliciter WordPress au moment où un visiteur clique réellement sur un ancien lien.
Ce qui aurait cassé sans cette étape
- Les backlinks accumulés depuis douze ans vers des URLs au format
.html - Les partages sur les réseaux sociaux archivés dans des captures d’écran ou des messages anciens
- Les citations dans d’autres blogs de la même niche, impossibles à faire corriger a posteriori
Une migration qui néglige les URLs historiques ne déplace pas un contenu, elle en efface une partie de l’audience acquise.
Le cas particulier des billets sans titre exploitable
Une dizaine de billets anciens, publiés à une époque où l’auteur ne renseignait qu’un titre générique du type Sans titre, ont posé un problème distinct : le slug généré automatiquement par WordPress à partir d’un tel titre entrait en collision avec plusieurs autres billets similaires. Ces cas isolés ont été traités manuellement, en forçant un slug unique directement dans le tableau de correspondance plutôt qu’en laissant l’import automatique en décider.
Vérification finale avant bascule
Avant la mise en production du nouveau front, un script a comparé systématiquement chaque ancienne URL du tableau de correspondance à la redirection effectivement générée, en s’assurant qu’aucune entrée n’avait été omise lors du passage entre l’export Atom et l’import WordPress.
En résumé
Préserver des URLs historiques lors d’une migration headless repose avant tout sur un travail de cartographie fait en amont, indépendant du contenu lui-même : extraire, associer, exposer via une route dédiée, puis vérifier exhaustivement avant bascule. Ce retour d’expérience ne traite volontairement pas du référencement du contenu une fois migré, qui relève d’un travail distinct mené après la stabilisation technique.



