rest_prepare_evenement. Voilà le filtre qui a résolu le problème posé par une plateforme d’agenda professionnel destinée aux organisateurs de salons B2B : comment garder le travail de référencement fait par Rank Math quand la page n’est plus rendue par WordPress, mais par un front Nuxt qui ne charge jamais le thème ni ses balises <head> ?
Rank Math génère ses métadonnées (titre optimisé, méta description, balises Open Graph, JSON-LD) au moment du rendu de la page, via des hooks accrochés à wp_head. En headless, ce moment n’existe simplement plus côté WordPress : la page HTML finale est assemblée ailleurs. Il fallait donc capturer cette sortie avant qu’elle ne soit perdue, et la faire voyager jusqu’au front par l’API REST.
Récupérer la sortie de Rank Math sans la réinventer
Rank Math expose une classe utile, RankMath\Helper, mais la méthode la plus fiable pour obtenir l’ensemble des balises déjà formatées reste de déclencher son mécanisme interne de génération de tête et de capturer le tampon de sortie. C’est moins élégant qu’un accès direct à un tableau de données, mais c’est ce qui garantit qu’on récupère exactement ce que Rank Math aurait affiché, y compris les réglages avancés configurés par l’équipe marketing dans son interface.
add_action( 'rest_api_init', function () {
    register_rest_field( 'evenement', 'seo_head', array(
        'get_callback' => function ( $post_array ) {
            if ( ! function_exists( 'rank_math' ) ) {
                return '';
            }
            global $post;
            $post = get_post( $post_array['id'] );
            setup_postdata( $post );

            ob_start();
            do_action( 'rank_math/head' );
            $html = ob_get_clean();

            wp_reset_postdata();
            return $html;
        },
        'schema' => array(
            'type'        => 'string',
            'description' => 'Bloc de balises SEO généré par Rank Math',
        ),
    ) );
} );
Ce que le front fait de ce bloc
Le champ seo_head arrive côté Nuxt comme une chaîne de caractères contenant les balises <title>, <meta> et le script JSON-LD. Le composant de mise en page les parse et les injecte dans les balises de tête via le module de gestion de tête de Nuxt, plutôt que de les insérer telles quelles dans le corps du document, ce qui aurait cassé leur portée.
Un point mérite d’être signalé : le JSON-LD généré par Rank Math pour un type Event contient des dates et un lieu, deux informations que Google utilise pour l’affichage enrichi dans les résultats de recherche. Perdre ce script en migrant vers un headless aurait fait reculer plusieurs mois de travail de référencement sur ces pages, ce qui a beaucoup pesé dans la décision de traiter ce sujet avant même le reste de la migration.
Trois variantes selon le type de contenu
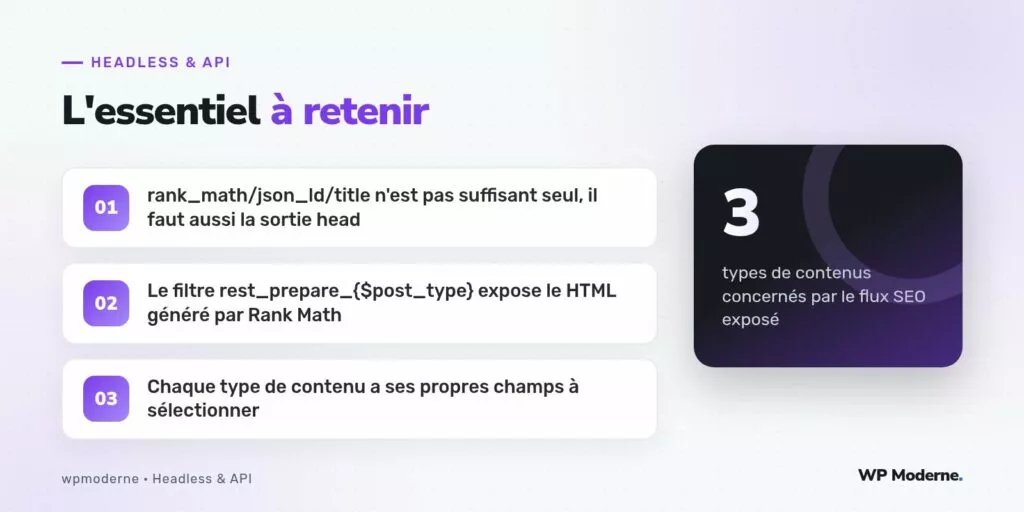
La plateforme distingue trois types de contenus, et chacun a nécessité un ajustement du filtre plutôt qu’une seule implémentation générique :
- Événement : le champ complet ci-dessus, avec JSON-LD de type
Eventincluant les dates de salon - Organisateur : un champ allégé, sans JSON-LD, car Rank Math n’y génère pas de schéma structuré pertinent pour ce type de fiche
- Page statique (mentions légales, à propos) : le champ complet, mais calculé une seule fois puis mis en cache pendant vingt-quatre heures via un transient, ces pages changeant rarement
Le piège du cache
La première version du filtre recalculait la sortie de Rank Math à chaque appel de l’API, ce qui multipliait les requêtes SQL sur les pages d’organisateurs consultées en boucle par le crawler du front pendant les phases de génération statique. La solution a été d’envelopper l’appel à rank_math/head dans un get_transient() / set_transient() invalidé à chaque sauvegarde du contenu via le hook save_post.
add_action( 'save_post_evenement', function ( $post_id ) {
    delete_transient( 'seo_head_' . $post_id );
} );
Une bonne règle sur ce genre de flux : ne jamais faire confiance à la vitesse d’un hook tiers dans un contexte d’API. Ce qui est instantané pour un visiteur qui charge une page l’est beaucoup moins pour un robot qui en appelle mille d’affilée.
Ce que cette approche laisse de côté
Le multilingue n’entre pas dans ce périmètre : la plateforme d’agenda ne publie qu’en français pour l’instant, et la question de faire cohabiter Rank Math avec une extension de traduction dans un contexte headless reste ouverte. C’est un sujet suffisamment dense pour mériter un traitement séparé plutôt qu’une réponse improvisée ici.
En résumé
Garder Rank Math en headless ne demande pas de renoncer à l’extension ni de recoder son moteur de règles SEO. Il suffit de capturer sa sortie au bon moment, de l’exposer proprement dans l’API, et de traiter chaque type de contenu selon ses besoins réels plutôt que d’appliquer un filtre générique partout. Le gain a été net : aucune régression de position mesurée sur les événements suivis avant et après la bascule.



