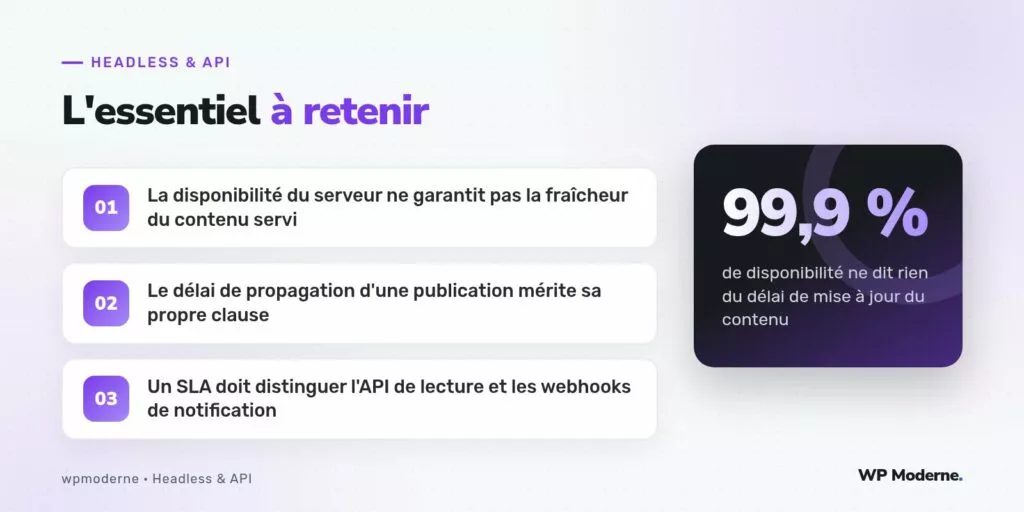
Que vaut un engagement de 99,9 % de disponibilité si le contenu servi par l’API date de trois heures alors qu’une correction urgente vient d’être publiée ? Cette question, rarement posée au moment de la rédaction d’un contrat, devient centrale dès qu’une agence s’engage à fournir une API headless en production pour un client dont l’activité dépend de la fraîcheur des données affichées.
Le réflexe consiste souvent à recopier un modèle de SLA classique, hérité de l’hébergement web traditionnel, en se contentant d’ajuster le taux de disponibilité attendu. Or une architecture découplée introduit des maillons supplémentaires — génération de contenu, propagation par webhook, reconstruction du front, invalidation de cache — dont aucun n’est couvert par la seule mesure de disponibilité du serveur WordPress.
Ce que mesure réellement la disponibilité serveur
Un indicateur de disponibilité classique vérifie qu’une requête HTTP vers le serveur reçoit une réponse dans un délai donné, avec un code de statut approprié. Sur une API WordPress, cela revient généralement à sonder une route comme /wp-json/ à intervalle régulier. Ce contrôle confirme que le serveur répond, pas que le contenu qu’il sert est à jour, ni que le pipeline complet qui mène jusqu’au visiteur final fonctionne de bout en bout.
Le maillon souvent oublié : la propagation
Entre le moment où un contenu est publié dans WordPress et celui où il apparaît réellement sur le front headless, plusieurs étapes s’enchaînent : déclenchement d’un webhook, file d’attente éventuelle côté plateforme d’hébergement du front, reconstruction ou revalidation des pages concernées, invalidation du cache du CDN. Chacune de ces étapes peut échouer indépendamment sans que la disponibilité du serveur WordPress n’en soit jamais affectée.
Les clauses qui manquent le plus souvent
Un SLA pensé pour une architecture headless gagne à distinguer explicitement plusieurs engagements, plutôt qu’un chiffre unique :
- Le taux de disponibilité de l’API de lecture, mesuré indépendamment de la disponibilité de l’interface d’administration.
- Le délai maximal de propagation entre une publication et son apparition sur le front, avec une définition précise du point de départ et du point d’arrivée de la mesure.
- Le comportement attendu en cas d’échec du webhook de notification : nouvelle tentative automatique, alerte, ou reconstruction planifiée de secours.
- Le délai de restauration en cas d’incident, distinct entre panne de l’API et panne du pipeline de publication.
Mesurer plutôt que promettre
Un engagement contractuel n’a de valeur que s’il s’appuie sur une mesure réelle et vérifiable. Pour une API headless, cela suppose de mettre en place une supervision qui couvre chaque étape du pipeline, pas seulement le serveur d’origine. Un contrôle synthétique typique consiste à publier périodiquement un contenu de test, puis à vérifier son apparition sur le front dans le délai contractuel, avant de le dépublier automatiquement.
#!/bin/bash
# Contrôle de bout en bout du pipeline de publication
POST_ID=$(wp post create --post_title="sonde-sla-$(date +%s)" \
  --post_status=publish --porcelain)

sleep 90

curl -sf "https://front.exemple.test/api/verifie-sonde/$POST_ID" \
  || echo "ALERTE : sonde absente du front apres 90s"

wp post delete "$POST_ID" --force
Qui porte quelle responsabilité
Un projet headless implique presque toujours au moins deux prestataires distincts, ou deux équipes internes distinctes : celle qui opère WordPress, celle qui opère le front et son hébergement. Un SLA mal rédigé attribue implicitement toute défaillance à l’un des deux camps, sans que le contrat ne clarifie où s’arrête la responsabilité de chacun. La zone grise se situe presque toujours au niveau du webhook : à qui incombe la vérification qu’il a bien été reçu et traité ?
Un exemple de répartition claire
Une répartition qui fonctionne en pratique consiste à définir la responsabilité de l’hébergeur WordPress jusqu’à l’émission effective du webhook, avec preuve d’envoi consignée dans un journal consultable, puis à transférer la responsabilité de la réception et du traitement à l’équipe qui opère le front. Cette frontière, si elle n’est pas écrite noir sur blanc, redevient un sujet de négociation à chaque incident.
Notre verdict
Un SLA calqué sur un modèle d’hébergement classique protège l’un des maillons d’une chaîne qui en compte plusieurs, et laisse sans filet exactement les points de défaillance les plus fréquents en architecture découplée. Rédiger un contrat qui nomme explicitement chaque étape du pipeline, avec sa propre mesure et sa propre responsabilité, coûte un effort de rédaction supplémentaire au démarrage, mais évite des mois de désaccords lors du premier incident venu.



