Un appel HTTP direct et une file d’attente répondent au même besoin — relayer un événement de WordPress vers un front découplé — mais pas avec la même robustesse face à la panne. Sur un projet e-commerce headless combinant WooCommerce, un webhook Stripe et un front Nuxt.js, cette différence a fini par coûter cher : une indisponibilité de dix minutes côté front a suffi à perdre plusieurs confirmations de paiement, jamais rejouées.
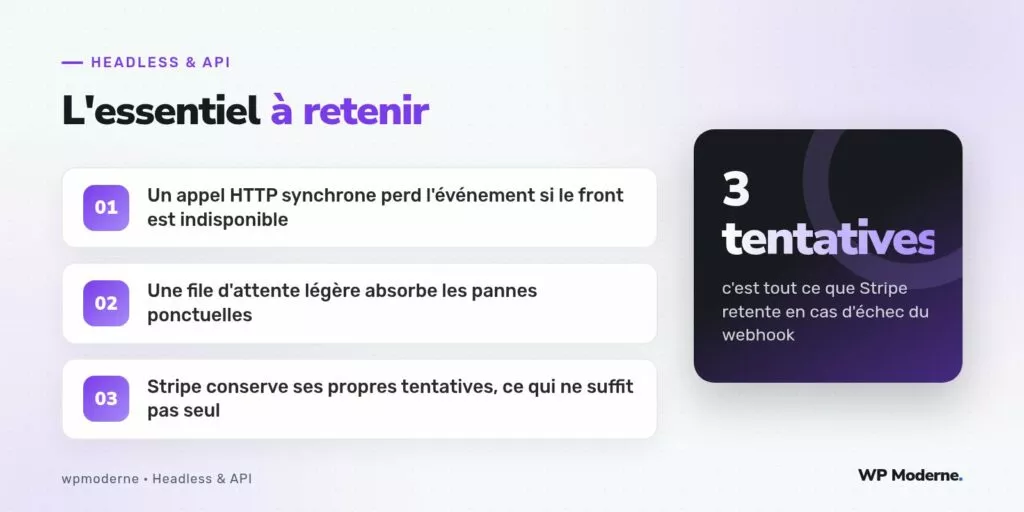
Le problème ne vient pas de Stripe, qui retente bien l’envoi de ses propres webhooks en cas d’échec. Il vient du relais intermédiaire, côté WordPress, qui transformait un événement Stripe en appel HTTP synchrone vers le front — sans aucun mécanisme de nouvelle tentative de son côté.
L’architecture initiale, et sa limite
Le flux initial suivait un schéma simple : Stripe déclenche un événement payment_intent.succeeded, WordPress le reçoit via un endpoint REST dédié, vérifie sa signature, met à jour la commande WooCommerce, puis appelle directement une route Nuxt (une fonction serverless côté front) pour déclencher l’envoi d’un e-mail de confirmation personnalisé et la mise à jour d’un tableau de bord côté client.
WordPress (endpoint webhook Stripe)
  └── verify_signature()
  └── update_order_status()
  └── POST https://front.exemple.fr/api/order-confirmed  ← appel synchrone, sans retry
Ce dernier appel, exécuté en synchrone dans le même cycle de requête que le webhook Stripe, ne disposait d’aucune tolérance à la panne : en cas de timeout, d’erreur 500 ou de déploiement en cours côté Nuxt, l’appel échouait silencieusement et l’événement n’était jamais rejoué. Stripe, de son côté, considérait le webhook comme traité avec succès dès que WordPress répondait 200 — ce qui était bien le cas, puisque la mise à jour de la commande WooCommerce, elle, avait réussi.
Pourquoi les tentatives de Stripe ne suffisent pas
Stripe retente l’envoi d’un webhook jusqu’à trois fois en cas d’échec de l’endpoint qu’il appelle directement, avec un intervalle croissant. Mais cette garantie s’arrête à la frontière de WordPress : une fois que l’endpoint REST a répondu 200, Stripe considère sa mission accomplie. Tout ce qui se passe ensuite — dont l’appel vers le front Nuxt — sort entièrement de son périmètre de responsabilité.
Introduire une file d’attente légère
La correction ne demandait pas une infrastructure de message broker complète : une table WordPress dédiée, jouant le rôle de file persistante, associée à une tâche planifiée via wp_schedule_event, suffisait à garantir qu’un échec de l’appel vers Nuxt ne se traduise plus jamais par une perte silencieuse.
WordPress (endpoint webhook Stripe)
  └── verify_signature()
  └── update_order_status()
  └── INSERT INTO wp_headless_relay_queue (payload, status='pending')

Cron WordPress (toutes les minutes)
  └── SELECT * FROM wp_headless_relay_queue WHERE status='pending'
  └── POST vers Nuxt
      ├── succès → status='done'
      └── echec  → attempts++, status='pending' (retente au prochain passage)
La table conserve chaque événement jusqu’à confirmation explicite de réception côté front, avec un compteur de tentatives et un plafond au-delà duquel l’événement passe en statut « échec » et déclenche une alerte manuelle plutôt qu’une nouvelle tentative infinie.
Le schéma de la table
CREATE TABLE wp_headless_relay_queue (
  id BIGINT UNSIGNED AUTO_INCREMENT PRIMARY KEY,
  payload LONGTEXT NOT NULL,
  status VARCHAR(20) NOT NULL DEFAULT 'pending',
  attempts SMALLINT UNSIGNED NOT NULL DEFAULT 0,
  created_at DATETIME NOT NULL,
  updated_at DATETIME NOT NULL
);
Ce que cette architecture change concrètement
- Une panne de dix minutes côté Nuxt ne fait plus perdre aucun événement : la file les retient jusqu’au retour du service.
- Le webhook Stripe répond toujours en quelques millisecondes, puisqu’il ne fait plus qu’écrire une ligne en base avant de répondre 200.
- Le traitement asynchrone via le cron WordPress reste limité par la fiabilité connue de
wp-cron, qui dépend du trafic réel du site pour se déclencher — un point de vigilance à part entière sur un site à faible trafic.
Une file d’attente n’a pas besoin d’être sophistiquée pour être utile : une table et un cron suffisent tant que le volume d’événements reste raisonnable. L’essentiel est qu’aucun événement ne disparaisse sans laisser de trace.
En résumé
Cette architecture ne traite volontairement pas la sécurisation du webhook lui-même — vérification de signature, protection contre le rejeu d’un même événement — qui reste un sujet distinct. Elle répond à une question plus étroite mais tout aussi critique : que se passe-t-il quand le service qui reçoit le relais est temporairement indisponible ? Avec une file persistante, la réponse devient : rien de grave, l’événement attend son tour.



