Warning: Maximum execution time of 30 seconds exceeded : ce message, apparu un mardi matin dans les journaux d’erreurs d’un site média consommé par un front découplé, ne donnait aucune indication sur la requête GraphQL en cause. WPGraphQL avait simplement fini par dépasser la limite d’exécution PHP, sans que personne n’ait vu venir la dégradation progressive qui y a mené.
Plutôt que d’attendre le prochain timeout pour enquêter dans l’urgence, l’équipe a mis en place une instrumentation permanente des résolveurs WPGraphQL les plus sollicités, avec remontée vers Sentry. L’objectif n’était pas de tout tracer, ce qui aurait noyé l’information utile, mais de cibler les champs connus pour être coûteux et de détecter leur dérive avant qu’elle ne devienne critique.
Le problème : une dégradation invisible jusqu’au timeout
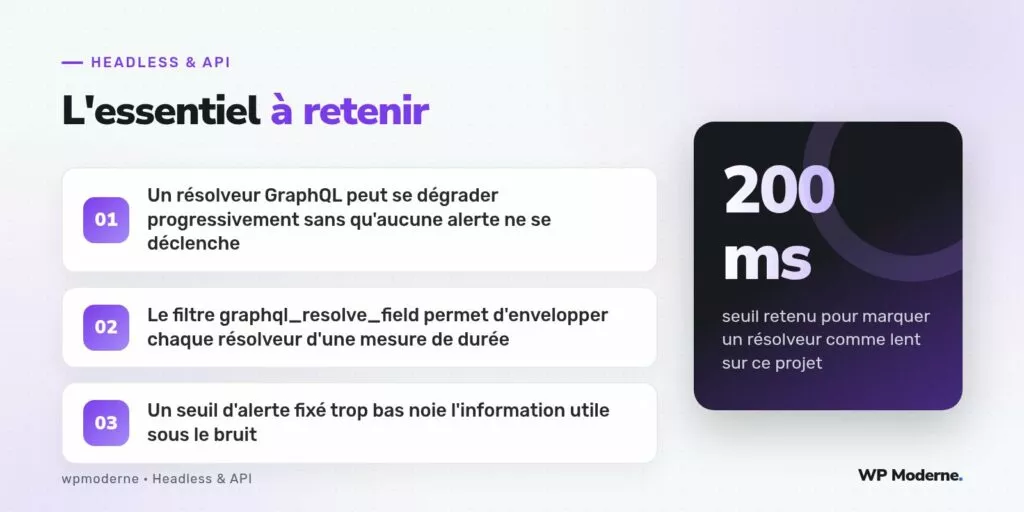
WPGraphQL exécute chaque requête en résolvant un graphe de champs, certains impliquant des jointures SQL supplémentaires (relations ACF, taxonomies imbriquées, champs calculés). Un résolveur qui prenait 50 millisecondes six mois plus tôt peut, avec la croissance du volume de contenu, glisser progressivement vers plusieurs secondes sans qu’aucune alerte classique de disponibilité ne se déclenche : le site répond toujours, juste plus lentement.
Sans instrumentation dédiée, ce type de dérive ne se révèle qu’au moment où elle franchit un seuil critique, généralement sous la forme d’un timeout PHP ou d’un abandon de requête côté client Apollo ou urql.
La solution : envelopper les résolveurs coûteux
WPGraphQL expose le filtre graphql_resolve_field, qui s’exécute autour de chaque résolution de champ. C’est le point d’accroche idéal pour mesurer une durée et la transmettre à Sentry via des transactions personnalisées :
add_filter('graphql_resolve_field', function ($result, $source, $args, $context, $info) {
    $champs_surveilles = ['posts', 'formations', 'sessions'];

    if (!in_array($info->fieldName, $champs_surveilles, true)) {
        return $result;
    }

    $debut = microtime(true);
    $span = \Sentry\SentrySdk::getCurrentHub()
        ->getSpan()
        ->startChild(new \Sentry\Tracing\SpanContext());
    $span->setOp('graphql.resolve');
    $span->setDescription($info->fieldName);

    add_action('shutdown', function () use ($span, $debut, $info) {
        $duree = (microtime(true) - $debut) * 1000;
        $span->setData(['duree_ms' => $duree]);
        $span->finish();

        if ($duree > 200) {
            \Sentry\captureMessage("Résolveur lent : {$info->fieldName} ({$duree}ms)");
        }
    });

    return $result;
}, 10, 5);
Le seuil de 200 millisecondes a été choisi après une semaine d’observation en environnement de production, en calculant la médiane des durées de résolution pour chaque champ surveillé et en fixant l’alerte à environ trois fois cette médiane.
Cibler plutôt que tout tracer
Envelopper l’intégralité des résolveurs, y compris les champs scalaires triviaux comme title ou slug, génère un volume de données inexploitable dans Sentry et alourdit chaque requête d’une mesure inutile. La liste des champs surveillés doit se limiter à ceux qui impliquent réellement une logique métier ou une requête supplémentaire :
- Les champs de relation ACF chargés via une sous-requête
- Les résolveurs personnalisés enregistrés avec
register_graphql_field - Les listes paginées avec un grand nombre de résultats potentiels
Lire les traces une fois l’alerte remontée
Une fois qu’une transaction Sentry signale un résolveur en dérive, le tableau de bord de traçage permet de visualiser la durée cumulée par champ sur une fenêtre glissante. Sur ce projet, la dérive détectée provenait d’un champ personnalisé recalculant à chaque requête la disponibilité de sessions de formation via une boucle sur des métadonnées non indexées.
Une alerte de performance qui arrive avant le ticket de support du client vaut largement le temps passé à l’écrire.
Variante : mesurer uniquement en environnement de production
Pour éviter de fausser les mesures locales avec Xdebug actif, l’instrumentation se limite à l’environnement de production via une constante dédiée :
if (defined('WP_ENVIRONMENT_TYPE') && WP_ENVIRONMENT_TYPE === 'production') {
    // enregistrement du filtre graphql_resolve_field
}
En résumé
Instrumenter les résolveurs WPGraphQL les plus coûteux avec Sentry transforme un timeout imprévisible en une alerte lisible plusieurs jours avant qu’elle ne devienne bloquante. La clé tient dans le choix du périmètre : surveiller les champs à risque, fixer un seuil issu d’une observation réelle, et laisser de côté les résolveurs triviaux pour ne pas diluer le signal utile dans le bruit.



