Une astreinte réveillée dix fois dans la même nuit pour des alertes qui, une fois examinées, ne demandaient aucune action immédiate : c’est le point de départ de l’audit qui a mené à la refonte du système d’alerte décrite dans ce billet.
Ce n’est pas un problème d’outil de supervision, déjà correctement choisi et déployé sur l’ensemble du parc de serveurs WordPress concerné. C’est un problème de configuration des seuils, ou plutôt de leur absence : la plupart des alertes déclenchaient une notification identique, qu’il s’agisse d’un serveur totalement injoignable ou d’un pic de charge processeur de trente secondes sans conséquence.
Ce qu’on observe : une astreinte qui n’ouvre plus les alertes
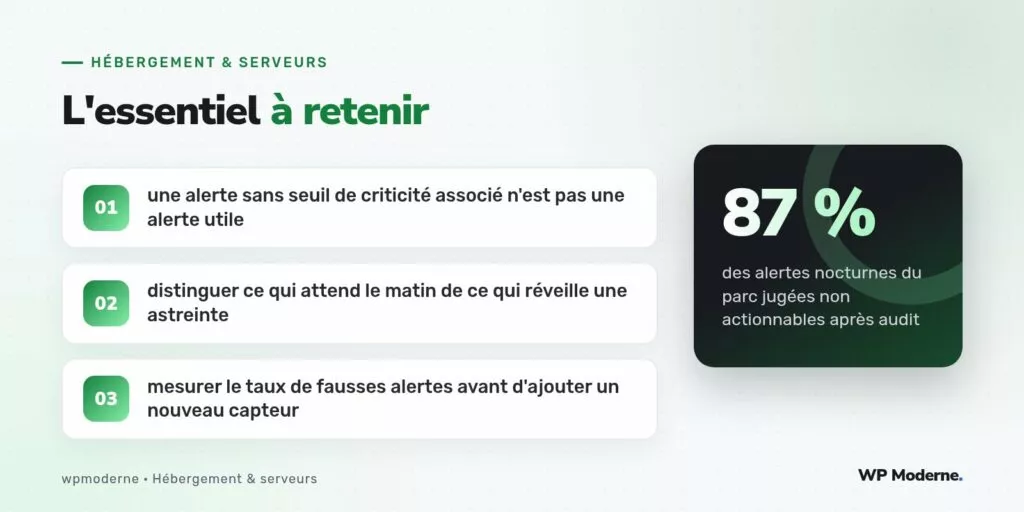
Après plusieurs mois de ce régime, le signal le plus révélateur n’était pas le nombre d’alertes reçues, mais le comportement de l’équipe d’astreinte face à elles : les notifications étaient de plus en plus souvent acquittées sans être lues en détail, y compris en pleine nuit, par réflexe d’épuisement plutôt que par analyse. Un audit rétrospectif sur un mois complet a montré que 87 % des alertes déclenchées entre vingt-deux heures et sept heures du matin ne demandaient, une fois examinées, aucune intervention immédiate.
Parmi les causes les plus fréquentes de ces fausses alertes : un pic de charge processeur de moins d’une minute lié à une tâche cron planifiée connue, une latence réseau ponctuelle sans impact visible côté visiteur, ou encore un espace disque qui repasse sous le seuil d’alerte après la purge automatique d’un cache, quelques minutes après le déclenchement.
Pourquoi c’est un problème, au-delà de la fatigue
Le risque principal n’est pas seulement humain, même si l’épuisement d’une astreinte réveillée sans raison valable a un coût réel et documenté sur la qualité de son jugement le lendemain. Le risque le plus grave est celui de l’alerte réellement critique noyée dans le bruit : quand la majorité des notifications ne demande aucune action, l’attention portée à chacune diminue mécaniquement, y compris pour celle qui, une nuit donnée, signale une panne réelle.
- Une astreinte qui reçoit trop d’alertes développe, sans le vouloir, une forme d’accoutumance qui ralentit sa réaction sur l’alerte qui compte vraiment.
- Un seuil unique appliqué à tous les serveurs du parc ignore que certains sites tolèrent naturellement des pics que d’autres, plus sensibles, ne devraient jamais atteindre.
- Sans distinction de criticité, il devient impossible de prioriser objectivement quelle alerte doit interrompre une astreinte et laquelle peut simplement attendre l’ouverture du bureau le lendemain matin.
Quoi faire : des seuils par niveau de criticité, pas par métrique brute
La refonte a consisté à définir, pour chaque métrique surveillée, trois seuils distincts plutôt qu’un seul : un seuil d’information qui alimente un tableau de bord sans notification active, un seuil d’alerte qui génère une notification consultable pendant les heures ouvrées, et un seuil critique, seul autorisé à réveiller une astreinte de nuit.
| Niveau | Exemple de déclencheur | Canal de notification |
|---|---|---|
| Information | Charge processeur au-dessus de la moyenne pendant moins de deux minutes | Tableau de bord, aucune notification |
| Alerte | Espace disque sous 15 % pendant plus de dix minutes | Canal de discussion d’équipe, en heures ouvrées |
| Critique | Serveur injoignable ou service HTTP en échec depuis plus de trois minutes | Appel téléphonique d’astreinte, à toute heure |
Le point le plus important de cette refonte n’a pas été le choix des chiffres eux-mêmes, mais l’exigence de persistance avant déclenchement : une métrique doit dépasser son seuil pendant une durée minimale, et pas seulement à l’instant précis de la mesure, pour être considérée. Un pic isolé de dix secondes, même très élevé, n’est jamais représentatif d’un incident réel sur ce type d’infrastructure.
Mesurer avant d’ajouter un nouveau capteur
Une règle a été instaurée pour toute nouvelle métrique surveillée : elle doit d’abord tourner un mois entier en mode information silencieuse, avec relevé du taux de faux positifs, avant d’être autorisée à générer la moindre notification active. Cette période d’observation a permis d’écarter plusieurs capteurs qui, sur le papier, semblaient pertinents mais qui, en pratique, n’auraient fait qu’ajouter du bruit supplémentaire.
Une alerte qui ne peut pas dire, à elle seule, si elle mérite d’interrompre une nuit de sommeil n’est pas encore une alerte prête pour la production.
En résumé
Le nombre d’alertes reçues par une astreinte n’est pas en soi un problème ; l’absence de hiérarchie entre elles en est un. Distinguer clairement ce qui informe, ce qui alerte et ce qui justifie de réveiller quelqu’un a permis, sur ce parc, de diviser par un facteur important le nombre d’appels nocturnes tout en améliorant, paradoxalement, le temps de réaction sur les incidents réellement critiques.