Trois environnements, trois bases de données, une seule règle absolue : aucun commit ne doit pouvoir atteindre la production sans être passé, dans l’ordre, par la recette puis la préproduction. C’est le principe fondateur d’une architecture de déploiement construite pour une équipe gérant plusieurs sites WordPress avec des cycles de mise à jour fréquents, où les tests unitaires du code déployé restent un chantier distinct, non couvert ici.
L’objectif de cette architecture n’est pas la rapidité du déploiement — un simple rsync suffirait pour cela — mais la capacité à détecter une régression avant qu’elle n’atteigne les visiteurs réels, tout en gardant une traçabilité complète de ce qui a été déployé, où, et par qui.
Vue d’ensemble de l’architecture
Dépôt Git
├── branche feature/*        → déploiement automatique sur recette
├── branche develop          → déploiement automatique sur préproduction
└── branche main             → déploiement manuel validé sur production

Environnements cibles
├── Recette
│   ├── Base de données isolée, purgée chaque semaine
│   └── Contenu anonymisé, jamais de données clients réelles
├── Préproduction
│   ├── Copie récente de la base de production, anonymisée
│   └── Configuration serveur identique à la production
└── Production
    ├── Base de données réelle
    └── Déploiement déclenché manuellement après validation
Le fichier de pipeline central
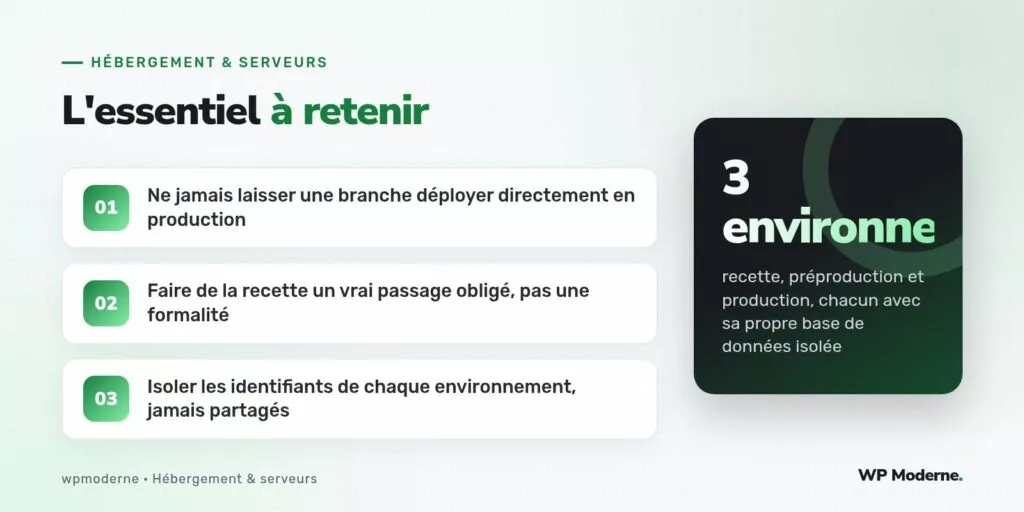
Le fichier .gitlab-ci.yml définit trois étapes successives, chacune conditionnée à la branche d’origine du commit, avec des règles de promotion strictes entre les environnements.
stages:
  - test
  - deploy_recette
  - deploy_preprod
  - deploy_prod

deploy_recette:
  stage: deploy_recette
  script:
    - ./scripts/deploy.sh recette
  rules:
    - if: '$CI_COMMIT_BRANCH =~ /^feature\//'

deploy_preprod:
  stage: deploy_preprod
  script:
    - ./scripts/deploy.sh preprod
  rules:
    - if: '$CI_COMMIT_BRANCH == "develop"'

deploy_prod:
  stage: deploy_prod
  script:
    - ./scripts/deploy.sh production
  rules:
    - if: '$CI_COMMIT_BRANCH == "main"'
  when: manual
  environment:
    name: production
Le mot-clé when: manual sur le déploiement de production n’est pas un détail accessoire : il impose une validation humaine explicite avant toute mise en ligne réelle, contrairement aux environnements de recette et de préproduction qui se déploient automatiquement à chaque commit sur leurs branches respectives, sans intervention manuelle.
Isolation des identifiants par environnement
Chaque environnement dispose de ses propres variables GitLab CI, scopées à son propre environnement déclaré, empêchant qu’une variable de production ne soit accessible depuis un pipeline déclenché sur une branche de recette.
- Clé SSH de déploiement distincte pour chaque environnement, avec des droits serveur limités au strict périmètre concerné.
- Identifiants de base de données propres à chaque environnement, jamais réutilisés d’un environnement à l’autre.
- Variables marquées « protégées », restreignant leur disponibilité aux seules branches explicitement autorisées à les utiliser.
Le passage obligé par la recette
Un point souvent négligé dans ce type d’architecture : la recette ne doit pas devenir une simple formalité traversée sans regard. Une checklist de validation minimale — vérification visuelle des pages critiques, test du formulaire de contact, contrôle du tunnel de commande le cas échéant — est exigée avant toute promotion vers la préproduction, consignée dans le ticket de suivi associé au déploiement.
La préproduction, miroir exact de la production
La préproduction se distingue de la recette par un détail essentiel : sa configuration serveur, version PHP, version de base de données et réglages de cache, est rigoureusement identique à celle de la production, alimentée par une copie récente et anonymisée de la base réelle. C’est le dernier filet avant la mise en ligne effective, celui qui révèle les régressions liées à un volume de données réaliste, invisibles sur une recette allégée.
Un repère qu’on applique sur chaque projet doté de cette architecture : une régression détectée en préproduction coûte une heure de correction ; la même régression détectée en production coûte une nuit blanche et la confiance du client.
En résumé
Une architecture de déploiement à trois environnements, articulée autour de GitLab CI, impose une discipline précise : promotion progressive d’un environnement à l’autre, isolation stricte des identifiants, et validation manuelle explicite avant toute mise en production. Cette rigueur, plus lourde à mettre en place qu’un simple script de copie, réduit considérablement le risque de régression visible par les visiteurs finaux du site.