Par où commence-t-on quand une recrue tout juste sortie de formation rejoint une équipe qui opère un parc de plusieurs centaines de sites WordPress mutualisés, sans jamais avoir touché à PHP-FPM, MySQL ou nginx en conditions réelles auparavant ? La question s’est posée concrètement à l’arrivée d’un administrateur système junior, et la réponse improvisée au début a rapidement montré ses limites.
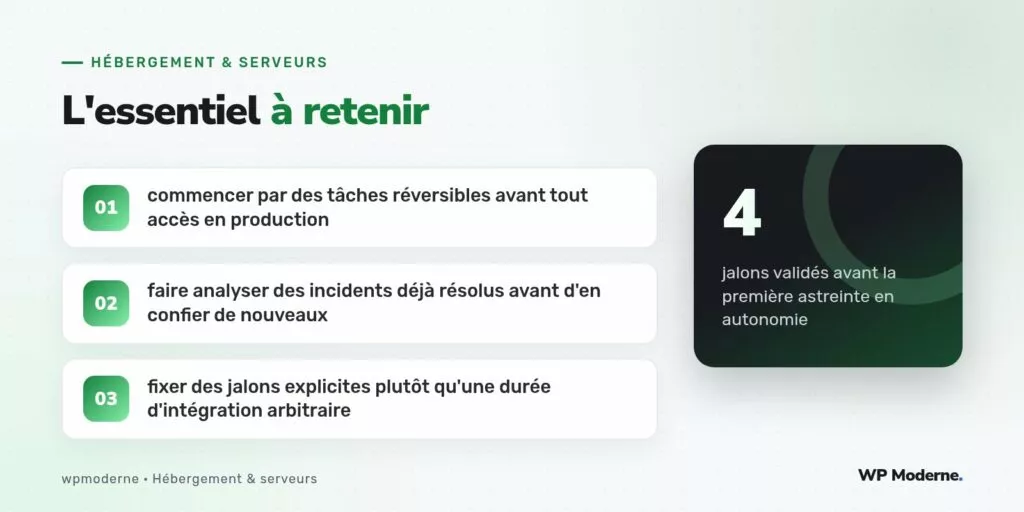
Ce billet détaille le parcours d’intégration mis en place ensuite, structuré en quatre jalons explicites, pensé pour faire progresser une recrue sans jamais l’exposer à un risque disproportionné pour le parc de production. Il ne traite pas du recrutement lui-même, déjà abordé ailleurs, mais de ce qui se passe une fois la personne arrivée.
Premier jalon : des tâches réversibles, sans accès direct à la production
Les premières semaines ont été consacrées exclusivement à un environnement de test répliquant fidèlement la stack de production, sans jamais donner d’accès en écriture sur les serveurs réels. Sur cet environnement, la recrue a pratiqué des tâches simples mais représentatives : redémarrage de services, lecture de journaux, modification contrôlée d’un fichier de configuration PHP-FPM, avec vérification systématique du résultat avant et après chaque manipulation.
- Aucune tâche de ce premier jalon n’avait de conséquence réelle si elle était mal exécutée, ce qui a permis à la recrue de se tromper sans crainte, condition jugée nécessaire à un apprentissage réel plutôt qu’à une simple récitation de procédures.
- Chaque exercice était accompagné d’une explication du pourquoi, pas seulement du comment : comprendre pourquoi un service redémarre proprement avec
systemctl reloadplutôt querestartcompte davantage, à terme, que la mémorisation de la commande elle-même.
Deuxième jalon : analyser des incidents déjà résolus
Une fois les bases acquises sur l’environnement de test, la recrue a été mise face à des rapports d’incidents réels déjà résolus par l’équipe, sans en connaître la conclusion à l’avance. L’exercice consistait à reproduire, à partir des seuls journaux archivés, le raisonnement qui avait mené au diagnostic initial, puis à comparer sa propre conclusion à celle réellement retenue à l’époque.
Cet exercice s’est révélé plus formateur que prévu : il expose la recrue à la diversité réelle des pannes rencontrées sur ce type de parc (saturation de pool PHP-FPM, verrou MySQL prolongé, certificat TLS expiré, espace disque saturé par des journaux non purgés) sans jamais engager sa responsabilité sur un incident réel en cours.
Troisième jalon : doublure sur incident réel, sans décision seule
Le troisième jalon a introduit la production réelle, mais toujours en doublure : la recrue observait un incident réel en cours de traitement par un membre confirmé de l’équipe, posait des questions en direct, proposait des hypothèses de diagnostic sans jamais exécuter elle-même une commande à effet réel sur les serveurs de production.
Ce jalon a révélé un écart inattendu
Un écart notable est apparu à ce stade : la recrue maîtrisait bien les commandes de diagnostic individuelles, mais peinait à enchaîner les hypothèses dans un ordre efficace face à un incident réel, sous une pression temporelle absente des exercices précédents. Ce constat a conduit à ajouter des simulations d’incident chronométrées avant de passer au jalon suivant, un ajustement qui n’était pas prévu dans le parcours initial.
Quatrième jalon : première astreinte en autonomie, avec filet de sécurité
La première astreinte assurée seule par la recrue s’est déroulée avec un membre confirmé de l’équipe joignable en second niveau, informé mais non sollicité par défaut. Cette astreinte de transition a duré un mois complet avant que la recrue ne rejoigne le roulement d’astreinte standard, sans filet particulier.
Une recrue qui n’a jamais été mise en situation de pression réelle avant sa première astreinte solitaire découvre cette pression au pire moment possible : en pleine nuit, seule, face à un incident réel.
Ce qui aurait pu être anticipé plus tôt
Le parcours initial ne prévoyait pas de jalon intermédiaire entre l’observation passive et l’astreinte en autonomie complète. L’ajout, en cours de route, de simulations chronométrées d’incidents fictifs a comblé cet écart, mais aurait gagné à être intégré dès la conception initiale du parcours plutôt qu’ajouté après avoir constaté la difficulté sur le terrain.
En résumé
Monter en compétence un administrateur système junior sur une stack WordPress mutualisée demande une progression par jalons explicites, chacun validé avant de passer au suivant, plutôt qu’une durée d’intégration fixée arbitrairement à l’avance. L’écart entre la maîtrise technique individuelle et la capacité à raisonner efficacement sous pression réelle mérite un jalon dédié, faute de quoi il ne se révèle qu’au pire moment : lors de la première astreinte assurée réellement seul.