Un pic de trafic sur un article de blog n’est censé faire trembler que le site vitrine qui l’héberge. Sur cette jeune startup SaaS, il a suffi d’une mention sur un forum technique très fréquenté pour qu’un article de blog WordPress capte des dizaines de milliers de visites en quelques heures, et que le produit lui-même, une application critique utilisée par des clients payants, devienne intermittent pour tout le monde.
La cause n’était pas un défaut du site vitrine en soi, mais un choix d’architecture pris au tout début du projet, quand mutualiser les ressources semblait raisonnable pour économiser un serveur supplémentaire : le site WordPress marketing et l’application produit partageaient le même serveur, le même pool PHP-FPM et, plus grave encore, la même instance de base de données.
Comment ce choix se met en place sans qu’on s’en rende compte
Ce type de mélange se construit rarement d’un coup. Il commence souvent par une décision ponctuelle et raisonnable en apparence : héberger le blog sur le même VPS que l’API du produit parce que la charge du site vitrine paraît négligeable au démarrage, quand la startup ne compte encore que quelques dizaines de visiteurs par jour. Le problème n’apparaît que lorsque l’un des deux systèmes change d’échelle plus vite que l’autre, ce qui est précisément le rôle d’un article de blog qui devient soudainement viral.
Ce que l’incident a révélé concrètement
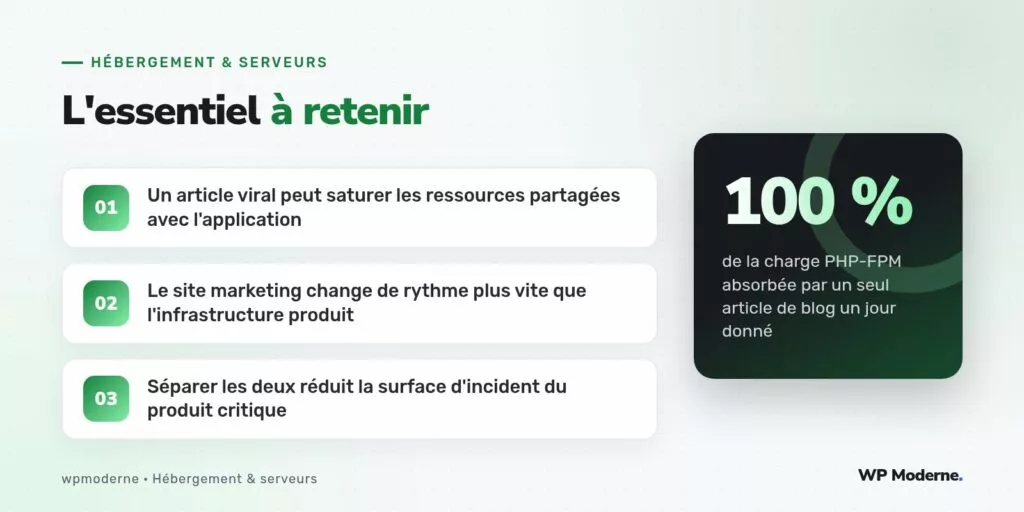
Le jour de l’incident, les journaux du pool PHP-FPM partagé montraient une saturation quasi totale des processus disponibles, tous occupés à servir des pages WordPress à des visiteurs venus lire un seul article. L’application produit, qui utilisait le même pool sans distinction de priorité, ne parvenait plus à obtenir de processus disponible pour répondre aux requêtes de ses propres clients, provoquant des temps de réponse dégradés puis des erreurs de délai dépassé côté API.
La configuration en cause ressemblait à ceci, un seul pool pour deux usages très différents :
[www]
user = deploy
group = deploy
listen = /run/php/php8.2-fpm.sock
pm = dynamic
pm.max_children = 20
pm.start_servers = 5
pm.min_spare_servers = 5
pm.max_spare_servers = 10
Vingt processus au total, partagés entre l’affichage d’un article de blog en cache partiel et le traitement de requêtes API, ne laissaient aucune marge de manœuvre en cas de pic sur l’un des deux usages.
La base de données, le vrai point de fragilité
Plus préoccupant encore que le partage de PHP-FPM, la base de données MySQL du produit et celle du site WordPress cohabitaient sur la même instance, sans limite de ressources distincte entre les deux. Une requête de blog mal optimisée, verrouillant une table plus longtemps que prévu, pouvait en théorie ralentir des requêtes du produit sans lien logique apparent, un couplage invisible tant qu’aucun incident ne le révèle.
Pourquoi c’est un problème structurel, pas ponctuel
Le site marketing d’une startup évolue à un rythme éditorial, avec des publications imprévisibles en termes d’audience. L’infrastructure produit, elle, doit respecter des exigences de disponibilité contractuelles envers des clients payants. Faire dépendre la seconde de la première revient à accepter qu’une décision purement éditoriale, publier tel article à tel moment, puisse avoir un impact direct sur la disponibilité contractuelle du produit.
La séparation mise en place après l’incident
La correction retenue n’a pas nécessité un changement d’hébergeur, seulement une redistribution claire des ressources :
- le site WordPress a été déplacé sur un serveur distinct, dimensionné pour absorber des pics de trafic éditoriaux sans lien avec le produit ;
- un cache de page complète a été mis en place sur le blog, réduisant drastiquement le nombre de requêtes atteignant réellement PHP-FPM lors d’un pic ;
- la base de données du produit a été isolée sur sa propre instance, avec ses propres limites de connexions et de ressources ;
- une politique simple a été formalisée : aucun système exposé aux clients payants ne partage de ressources avec le site marketing.
Un site vitrine et un produit critique n’ont jamais le même contrat de disponibilité : les faire cohabiter revient à donner au premier le pouvoir de faire tomber le second.
Notre verdict
Mélanger site marketing WordPress et infrastructure produit part souvent d’une intention d’économie parfaitement compréhensible au lancement d’une startup, quand chaque euro compte. Le problème apparaît dès que l’un des deux systèmes connaît une variation d’usage que l’autre ne peut pas absorber sans dommage collatéral. La séparation, même minimale, entre le serveur qui sert le blog et celui qui sert le produit devrait être posée comme un principe non négociable dès que le produit compte son premier client payant, pas après le premier incident.