« Puis-je payer en plusieurs fois avec une carte étrangère ? » Cette question, apparue dans la FAQ générée automatiquement pour ce site de vente d’équipements sportifs, n’a jamais été posée par un seul client en deux ans d’historique de tickets. Elle sonnait pourtant parfaitement plausible, au point que personne dans l’équipe ne l’avait repérée avant la mise en ligne de la page.
Ce billet ne traite pas la configuration du centre d’appel, déjà en place par ailleurs, mais uniquement ce symptôme de questions inventées et la manière dont il a été corrigé.
Le symptôme : des questions jamais posées
Le générateur de FAQ, construit autour d’un LLM chargé de produire des questions-réponses à partir de la description des produits et des politiques du site, produisait des contenus grammaticalement irréprochables et parfaitement crédibles. Le problème n’est apparu qu’après un audit croisé avec les tickets réels du support, hébergés dans HubSpot : sur 50 questions générées, 20 ne correspondaient à aucune préoccupation jamais remontée par un client réel.
Ces questions inventées n’étaient pas absurdes — elles auraient pu être posées, en théorie. Le problème est justement là : leur plausibilité rendait leur détection impossible sans comparaison systématique avec les données réelles du support client.
Le diagnostic : un prompt sans ancrage
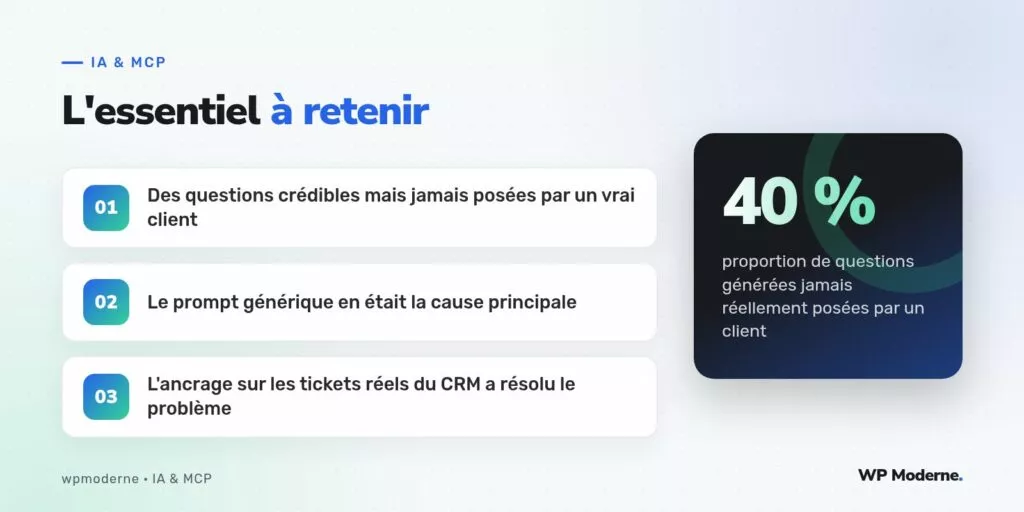
Le prompt initial demandait simplement : « Génère les 50 questions les plus susceptibles d’être posées par un client sur ce produit. » Rien dans cette instruction n’obligeait le modèle à se baser sur des données réelles : il générait des questions statistiquement plausibles pour ce type de produit, sans lien avec les préoccupations effectives des clients de ce site en particulier.
C’est un cas classique où le modèle ne « ment » pas au sens propre : il répond exactement à la demande formulée, produire des questions plausibles. Le problème vient de la demande elle-même, qui ne précisait aucune source de vérité à respecter.
Le correctif : s’appuyer sur les tickets réels
Le prompt a été entièrement réécrit pour imposer un ancrage sur les tickets HubSpot existants, récupérés via l’API avant chaque génération :
function recuperer_tickets_recents_hubspot( $produit_id ) {
    $response = wp_remote_get(
        'https://api.hubapi.com/crm/v3/objects/tickets/search',
        array(
            'headers' => array(
                'Authorization' => 'Bearer ' . HUBSPOT_TOKEN,
                'Content-Type'  => 'application/json',
            ),
            'body' => wp_json_encode( array(
                'filterGroups' => array( array(
                    'filters' => array( array(
                        'propertyName' => 'produit_associe',
                        'operator'     => 'EQ',
                        'value'        => $produit_id,
                    ) ),
                ) ),
                'limit' => 50,
            ) ),
        )
    );

    return json_decode( wp_remote_retrieve_body( $response ), true );
}
Le prompt final incluait ensuite un extrait de ces tickets réels, avec une consigne explicite : « Génère des questions de FAQ uniquement à partir des préoccupations exprimées dans les tickets fournis ci-dessous. N’invente aucune question qui n’y trouve pas d’écho direct ou indirect. »
Les résultats après correction
- Sur le lot suivant de 50 questions, 46 correspondaient directement à une préoccupation identifiable dans les tickets fournis.
- Les quatre questions restantes ont été jugées acceptables après relecture, comme des reformulations légitimes de préoccupations réelles.
- Aucune question totalement déconnectée du comportement réel des clients n’a été détectée sur ce second lot.
Un générateur de FAQ sans données réelles en entrée ne génère pas une FAQ : il génère une fiction plausible sur ce que pourraient être les questions des clients, ce qui n’est jamais tout à fait la même chose.
En résumé
Une FAQ générée par IA sans ancrage sur des données de support réelles finit toujours par inventer des préoccupations qui n’existent pas, avec un niveau de plausibilité qui rend le problème difficile à détecter sans audit croisé. Relier le prompt aux tickets réels du CRM, plutôt que de laisser le modèle deviner, reste la correction la plus directe et la plus durable.