Peut-on utiliser un LLM pour reformuler des comptes rendus médicaux à destination des patients, sans qu’aucune donnée sensible ne transite par un serveur tiers ? C’est la question posée par ce centre de soins ambulatoires, qui souhaitait simplifier la formulation de ses comptes rendus de consultation avant leur mise à disposition sur l’espace patient du site.
La réponse a fini par exclure d’emblée toute API de LLM hébergée par un fournisseur externe. L’hébergement des données de santé dans son ensemble, sujet réglementaire à part entière, n’est pas traité en détail ici.
Le blocage réglementaire et contractuel
Transmettre un extrait de compte rendu médical, même partiellement anonymisé, à une API tierce de LLM posait un problème de conformité que le service juridique de l’établissement a jugé insurmontable dans les délais impartis : aucun contrat de sous-traitance conforme n’avait été négocié avec les fournisseurs de LLM disponibles à cette date, et la nature des données en jeu rendait cette négociation particulièrement sensible.
Plutôt que d’attendre une hypothétique validation juridique, l’équipe technique a exploré une alternative : faire tourner un modèle de langage open source directement sur un serveur interne à l’établissement, sans aucune connexion sortante vers un service tiers.
Le choix du modèle auto-hébergé
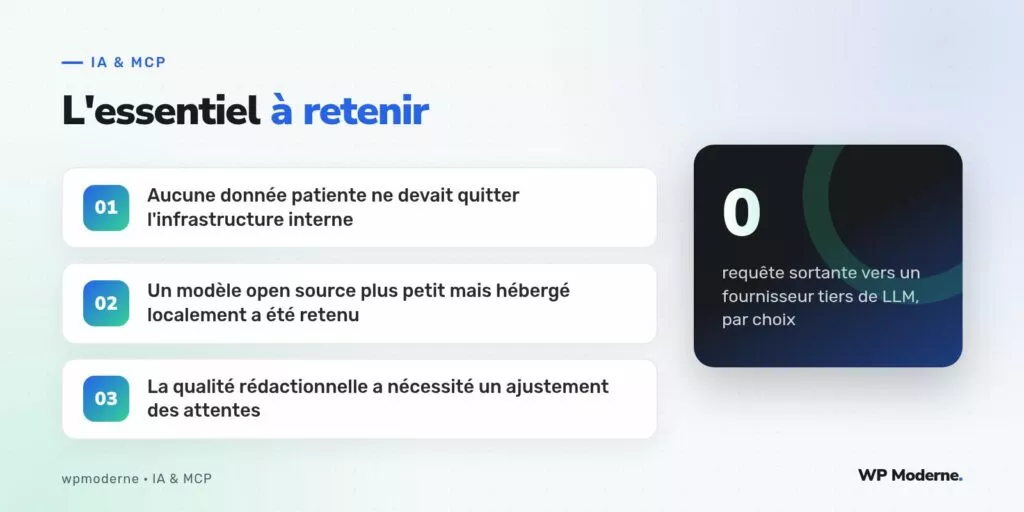
Le modèle retenu, plus modeste en taille que les API grand public disponibles à cette date, a été déployé sur un serveur dédié disposant d’une carte graphique suffisante pour un temps de réponse acceptable. Aucune requête HTTP sortante n’était nécessaire pour générer une reformulation : tout le traitement restait dans le périmètre réseau de l’établissement.
{
  "modele": "modele-open-source-7b",
  "hebergement": "serveur interne, GPU dedie",
  "connexion_sortante": false,
  "donnees_transmises_hors_infrastructure": 0
}
Cette configuration excluait de fait tout risque de fuite de données patiente vers un tiers, au prix d’une infrastructure à maintenir en interne, avec son lot de mises à jour et de supervision technique habituellement délégué à un fournisseur d’API.
Le compromis sur la qualité rédactionnelle
Le modèle auto-hébergé, plus petit que les modèles disponibles via API, produisait des reformulations globalement correctes mais moins nuancées, avec parfois une simplification excessive de termes médicaux dont la précision importait pourtant pour le patient. Un prompt plus directif, accompagné d’exemples de reformulations validées par l’équipe médicale, a permis de réduire ce défaut sans le faire disparaître complètement.
- Reformulations globalement fidèles sur les comptes rendus standards.
- Simplification parfois excessive sur les termes médicaux rares ou spécifiques.
- Nécessité d’une relecture systématique par un professionnel de santé avant diffusion au patient.
Le coût réel de l’auto-hébergement
Le serveur dédié a représenté un investissement initial que l’établissement n’aurait pas engagé pour un simple usage éditorial classique. Ce coût a été justifié uniquement par la contrainte de confidentialité, jugée non négociable par la direction médicale. Sur un usage sans donnée sensible, l’équipe technique reconnaît volontiers qu’une API tierce classique aurait été bien plus rentable.
L’auto-hébergement d’un LLM n’est jamais le choix le plus simple ni le plus économique : il ne se justifie que lorsque la contrainte de confidentialité rend toute alternative tout simplement impossible à envisager.
En résumé
Pour ce site de santé, le choix d’un LLM auto-hébergé n’a rien d’un effet de mode technique : c’est une réponse directe à une contrainte de confidentialité qui excluait toute autre option. Le compromis sur la qualité rédactionnelle, réel mais gérable avec une relecture professionnelle systématique, reste un prix jugé acceptable au regard de la garantie qu’aucune donnée patiente ne quitte l’infrastructure de l’établissement.
L’établissement prévoit désormais de réévaluer ce choix à intervalle régulier, à mesure que des modèles open source plus performants deviennent disponibles pour un déploiement local équivalent. La contrainte de confidentialité, elle, ne bougera pas : c’est elle qui continuera de dicter le choix entre auto-hébergement et API tierce, bien avant toute considération de qualité rédactionnelle ou de coût d’infrastructure.