Pourquoi les recommandations d’articles générées à partir des titres devenaient-elles incohérentes uniquement sur certains titres, sans logique apparente au premier regard ? L’anomalie touchait spécifiquement les titres contenant des caractères accentués en fin de chaîne tronquée, ou un emoji utilisé volontairement par la rédaction dans certains intitulés.
Le code responsable limitait la longueur du titre envoyé à l’API d’embedding à cent caractères, une précaution raisonnable pour éviter d’envoyer des titres anormalement longs. Le problème résidait dans la fonction utilisée pour cette troncature.
Symptôme
Un titre comme « Comment améliorer la sécurité de votre boutique en ligne 🔒 » produisait, une fois tronqué puis envoyé à l’API, un vecteur incohérent avec des articles pourtant proches par le sujet. D’autres titres, sans caractère accentué en fin de troncature, ne présentaient aucune anomalie.
Diagnostic
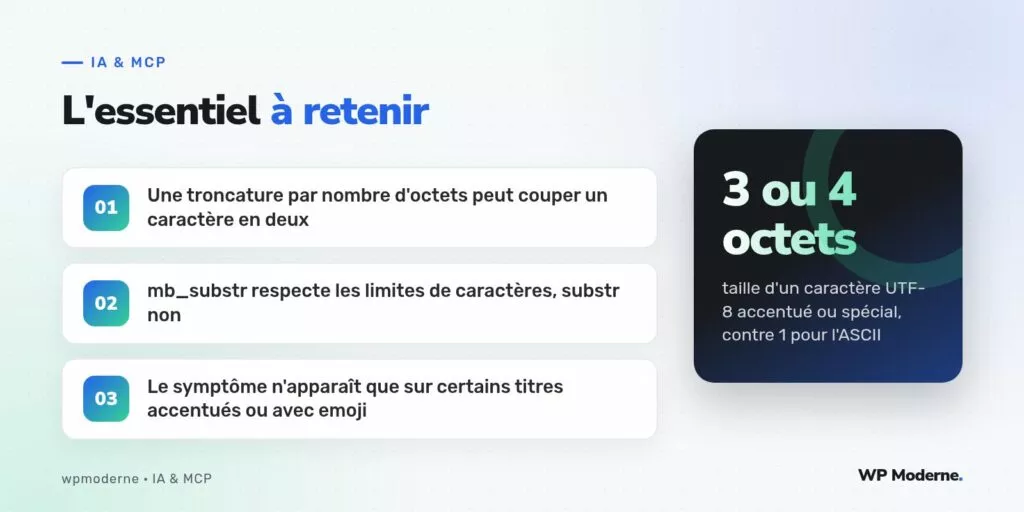
Le code en cause utilisait substr(), une fonction qui découpe une chaîne par nombre d’octets, et non par nombre de caractères :
$titre_tronque = substr( $titre, 0, 100 );
En UTF-8, un caractère accentué comme « é » occupe deux octets, et un emoji peut en occuper quatre. Si la limite de cent octets tombe au milieu de la séquence d’octets d’un même caractère, substr() découpe ce caractère en deux, produisant une séquence d’octets invalide en UTF-8.
var_dump( mb_check_encoding( $titre_tronque, 'UTF-8' ) );
// bool(false) sur les titres affectés
Cette séquence invalide, une fois envoyée à l’API sous forme de texte, était acceptée par certaines implémentations qui remplacent silencieusement le caractère invalide par un caractère de remplacement, ou provoquait un rejet variable selon l’API utilisée. Dans les deux cas, le texte réellement pris en compte pour générer l’embedding différait du titre original, d’où l’incohérence du vecteur produit.
Correctif
Remplacer substr() par mb_substr(), qui découpe par nombre de caractères et non par nombre d’octets, résout le problème à la racine :
$titre_tronque = mb_substr( $titre, 0, 100, 'UTF-8' );
Cette fonction respecte les limites de chaque caractère multi-octet et ne coupe jamais une séquence UTF-8 au milieu, quelle que soit la composition du titre en entrée.
Ajouter une vérification de sécurité
Une vérification systématique avant l’envoi, avec mb_check_encoding(), permet de détecter d’éventuels textes invalides provenant d’autres sources que la simple troncature, par exemple un import de contenu depuis un fichier mal encodé :
function preparer_titre_pour_embedding( string $titre ): string {
    $titre_tronque = mb_substr( $titre, 0, 100, 'UTF-8' );

    if ( ! mb_check_encoding( $titre_tronque, 'UTF-8' ) ) {
        $titre_tronque = mb_convert_encoding( $titre_tronque, 'UTF-8', 'UTF-8' );
    }

    return $titre_tronque;
}
Prévention
Cet incident a conduit à une règle de code plus générale au sein de l’équipe : toute manipulation de chaîne de caractères issue d’un contenu utilisateur ou éditorial doit utiliser les fonctions préfixées mb_, jamais leurs équivalents historiques sans préfixe, sauf cas très spécifique justifié en commentaire.
mb_substr()plutôt quesubstr()pour toute troncature de textemb_strlen()plutôt questrlen()pour toute limite de longueurmb_str_split()plutôt questr_split()pour tout découpage caractère par caractère
Une fonction de chaîne qui ignore l’encodage multi-octet reste correcte sur du texte purement ASCII et devient une source de bogue silencieux dès qu’un accent ou un emoji apparaît dans le contenu réel du site.
Ce qu’il faut retenir
Ce type d’anomalie ne se manifeste pas de façon systématique : elle dépend de la composition exacte du texte tronqué, ce qui la rend difficile à reproduire sans connaître la cause. La vigilance sur le choix des fonctions de manipulation de chaîne, dès l’écriture initiale du code, évite ce genre de piège bien avant qu’il n’affecte un traitement aussi sensible qu’un embedding.