wp podcast:generate --module=42. Cette commande, ajoutée à la CLI maison de la plateforme de formation Academia Flow, déclenche l’ensemble du pipeline décrit dans cet article : récupération de la transcription d’un module, résumé par un LLM, puis synthèse vocale du résultat en un fichier audio de quelques minutes.
L’objectif de ce chantier n’était pas de remplacer le cours original, mais d’offrir aux apprenants un format alternatif pour réviser un module déjà suivi, écoutable en podcast pendant un trajet plutôt qu’en revisionnant une vidéo de quatre-vingt-dix minutes. Le contenu pédagogique de chaque module reste hors de portée de ce traitement : seule la forme du résumé change, jamais le fond enseigné par le formateur.
Étape 1 : préparer une transcription exploitable
La plateforme dispose déjà d’une transcription textuelle de chaque module vidéo, générée lors de leur mise en ligne à des fins de sous-titrage. Cette transcription brute contient des hésitations, des répétitions et des marqueurs de temps qui n’ont aucun intérêt pour un résumé : la première étape du pipeline consiste à la nettoyer, en supprimant les répétitions et en recollant les phrases coupées par les changements de plan vidéo.
Ce nettoyage, réalisé par un script simple avant tout appel au LLM, réduit considérablement la longueur du texte à traiter et améliore la qualité du résumé produit ensuite, un modèle de langage ayant plus de mal à ignorer le bruit qu’à travailler sur un texte déjà propre.
Étape 2 : générer un résumé pensé pour l’oral
Le prompt envoyé au modèle précise explicitement que le résultat sera lu à voix haute par une synthèse vocale, pas affiché à l’écran : consigne de rédiger des phrases courtes, d’éviter les énumérations à puces qui ne se prononcent pas naturellement, et de reformuler les références visuelles du cours original (« comme on le voit sur ce schéma ») en descriptions verbales autonomes.
const prompt = `Resume ce module de formation en 300 mots maximum,
pour une lecture a voix haute par synthese vocale.
Phrases courtes. Pas de listes a puces. Pas de reference
visuelle du type "comme montre ce schema".
Transcription nettoyee :
${cleanedTranscript}`;
Étape 3 : découper le texte avant la synthèse
La plupart des moteurs de synthèse vocale imposent une limite de caractères par requête, bien inférieure à la longueur d’un résumé de 300 mots accompagné de ses transitions. Le résumé généré est donc découpé en segments d’une ou deux phrases, chacun envoyé séparément à l’API de synthèse, puis les fichiers audio obtenus sont concaténés dans l’ordre d’origine.
- Découper le résumé en segments de moins de 200 caractères, en respectant les frontières de phrases.
- Envoyer chaque segment à l’API de synthèse vocale avec la même voix et les mêmes paramètres de vitesse.
- Concaténer les fichiers audio obtenus avec un outil de traitement audio en ligne de commande.
- Ajouter un signal sonore court en introduction et en conclusion du résumé pour le distinguer du cours original.
Étape 4 : le contrôle qualité avant publication
Un résumé audio mal prononcé (un sigle technique lu lettre par lettre au lieu d’être épelé, un nom propre mal accentué) ruine l’expérience d’écoute bien plus vite qu’une coquille dans un texte affiché à l’écran, que le lecteur corrige mentalement sans même y penser. Chaque résumé généré est donc écouté intégralement par un membre de l’équipe pédagogique avant sa mise en ligne, avec une grille de vérification courte mais systématique.
- Prononciation correcte des termes techniques propres au domaine du module.
- Absence de contresens introduit par le résumé par rapport au contenu original.
- Fluidité des transitions entre les segments audio concaténés, sans coupure audible.
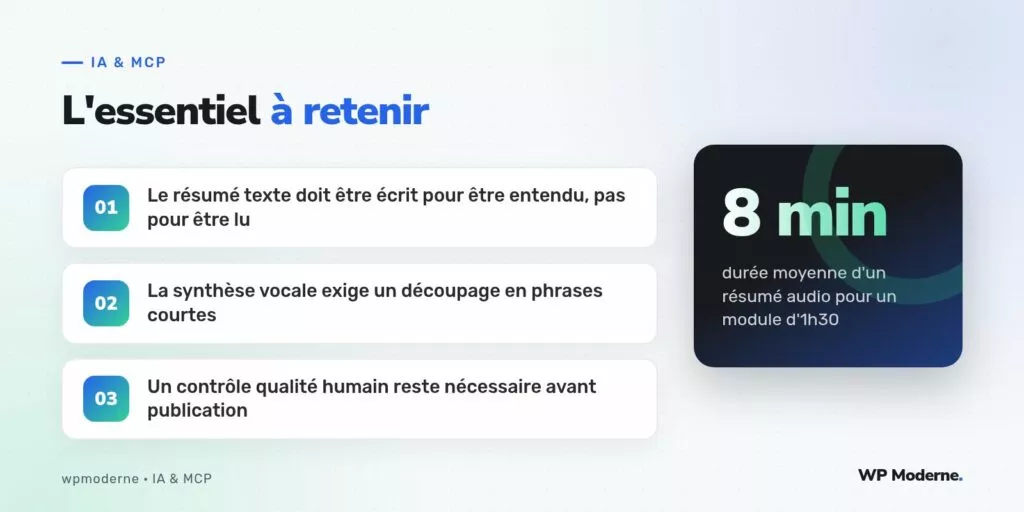
Un résumé écrit pour être lu et un résumé écrit pour être entendu ne sont pas le même texte : la différence se joue autant dans la ponctuation que dans le choix des mots.
Ce que ce pipeline ne fait pas
Il ne remplace ni le cours vidéo original ni son contenu pédagogique, sur lequel ce chantier n’a aucune prise et aucune ambition. Il ne génère pas non plus de résumé pour les modules comportant principalement des démonstrations pratiques à l’écran, jugés peu adaptés à une restitution purement audio et volontairement exclus du périmètre.
En résumé
Huit minutes en moyenne, pour un module d’une heure trente : le format audio ne cherche pas l’exhaustivité mais la révision rapide. Le soin apporté à la préparation du texte, pensé dès le prompt pour une lecture orale, s’est révélé plus déterminant pour la qualité finale que le choix du moteur de synthèse vocale lui-même.