"required": ["reference", "categorie", "diametre_mm", "materiau", "compatible_avec"] — cette seule ligne, ajoutée à la définition d’un schéma JSON, a suffi à éliminer la quasi-totalité des fiches produit incomplètes générées pour le catalogue de pièces détachées d’un négociant en matériel BTP.
Le catalogue compte plusieurs centaines de références de pièces (joints, raccords, filtres) dont les fiches techniques d’origine, fournies par les fabricants sous forme de tableaux PDF hétérogènes, devaient être converties en fiches produit structurées pour le site WordPress. Un premier essai avec un prompt en texte libre, demandant simplement de « renvoyer un JSON avec les caractéristiques de la pièce », a produit un résultat inexploitable en l’état.
Le problème du prompt en texte libre
Sans contrainte de format explicite, un LLM varie la structure de sa réponse selon la formulation de la fiche source : un champ nommé diametre dans une réponse devient diametre_mm dans une autre, un champ optionnel disparaît totalement quand l’information n’est pas présente dans le texte source, sans qu’aucune valeur nulle ne signale son absence.
Sur les quatre cents premières fiches traitées avec cette approche, trente-sept présentaient au moins un champ manquant ou renommé, ce qui obligeait à une vérification manuelle systématique avant tout import dans le catalogue — un travail presque aussi long que la saisie manuelle que l’automatisation était censée éviter.
Passage à un schéma JSON strict
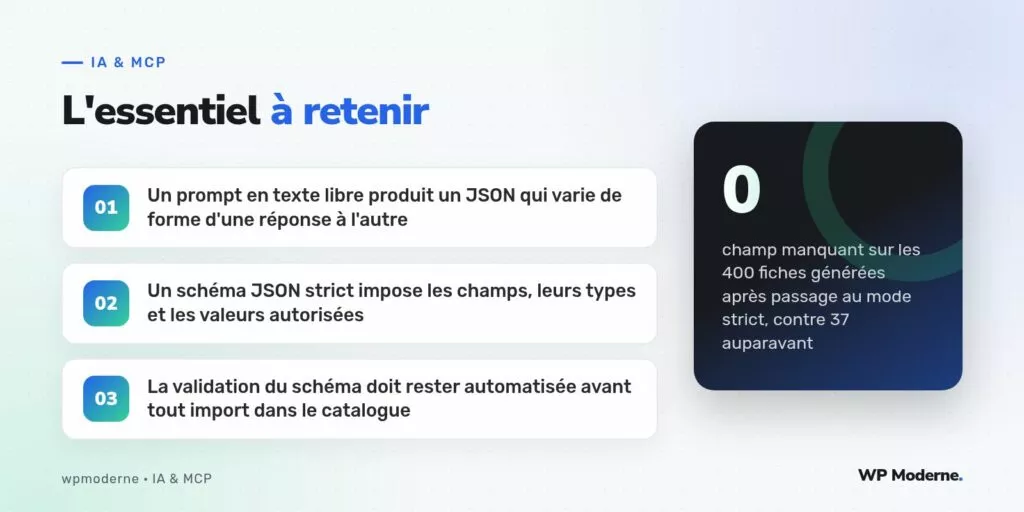
La solution consiste à fournir au modèle un schéma JSON complet, avec chaque champ, son type et, quand c’est pertinent, la liste des valeurs autorisées. La plupart des API de LLM récentes acceptent un mode de sortie structurée qui garantit que la réponse respecte ce schéma, plutôt que de simplement l’espérer via une consigne textuelle.
{
  "type": "object",
  "properties": {
    "reference": { "type": "string" },
    "categorie": {
      "type": "string",
      "enum": ["joint", "raccord", "filtre", "collier"]
    },
    "diametre_mm": { "type": "number" },
    "materiau": {
      "type": "string",
      "enum": ["laiton", "acier inoxydable", "pvc", "caoutchouc"]
    },
    "compatible_avec": {
      "type": "array",
      "items": { "type": "string" }
    }
  },
  "required": ["reference", "categorie", "diametre_mm", "materiau", "compatible_avec"],
  "additionalProperties": false
}
L’ajout de "additionalProperties": false s’est révélé aussi important que la liste des champs obligatoires : sans cette contrainte, le modèle ajoutait parfois des champs supplémentaires non prévus par la nomenclature du catalogue, qui se retrouvaient ensuite orphelins lors de l’import.
Le résultat après passage au mode strict
Sur les quatre cents fiches suivantes, générées avec ce schéma strict, aucun champ obligatoire n’était manquant. Le contrôle qualité restant à effectuer se limite désormais à vérifier l’exactitude des valeurs elles-mêmes — un diamètre mal lu sur un PDF source, par exemple — plutôt que la structure de la réponse.
Cette distinction est importante : un schéma strict garantit la forme de la réponse, jamais son exactitude factuelle. Une pièce technique mal identifiée dans le PDF d’origine restera mal identifiée dans le JSON généré, même avec le schéma le plus rigoureux.
Adapter le schéma à la nomenclature
La liste des valeurs autorisées pour les champs categorie et materiau doit refléter exactement la nomenclature interne du catalogue, pas une classification générique. Un négociant qui distingue le laiton chromé du laiton brut, par exemple, doit intégrer cette distinction dans l’énumération du schéma, sous peine de voir le modèle regrouper les deux sous une seule valeur approximative.
- Lister d’abord la nomenclature réelle utilisée en interne, avant d’écrire le schéma.
- Tester le schéma sur un échantillon volontairement hétérogène de fiches sources, pas uniquement sur les cas les plus simples.
- Prévoir un champ de confiance ou de commentaire libre, alimenté par le modèle, pour signaler les cas ambigus plutôt que de les deviner silencieusement.
Un schéma JSON strict ne rend pas un modèle plus intelligent, il l’empêche simplement d’improviser une structure différente à chaque réponse — ce qui, pour un import massif, compte davantage que la qualité rédactionnelle du texte.
En résumé
Pour peupler un catalogue technique à partir de données hétérogènes, un schéma JSON strict transforme un LLM en outil de conversion fiable, à condition que la nomenclature du schéma corresponde exactement à celle utilisée en interne. La question de l’indexation de ces fiches dans un moteur de recherche interne reste un sujet séparé, à traiter une fois le catalogue peuplé de données propres.