GPT-4 et Claude sont tous deux disponibles depuis mars 2023, et une startup SaaS parisienne qui développe une extension WordPress interne pour la gestion de ses abonnements s’est posé une question très concrète deux mois plus tard : lequel des deux convient le mieux pour documenter ce plugin, jusque-là dépourvu de toute documentation technique à jour ?
Le contexte est celui de nombreuses jeunes équipes techniques : un plugin développé rapidement, une documentation qui n’a jamais suivi le rythme des évolutions du code, et une nouvelle recrue qui peine à comprendre l’architecture sans poser dix questions par jour à l’équipe en place.
Le protocole de comparaison retenu
L’équipe a soumis aux deux modèles le même corpus : une trentaine de fichiers PHP du plugin, incluant les hooks personnalisés déclarés via add_action() et add_filter(), ainsi que la structure des tables personnalisées créées à l’activation. La consigne demandait, dans les deux cas, un document de référence par classe principale, avec description du rôle, liste des méthodes publiques et un exemple d’utilisation.
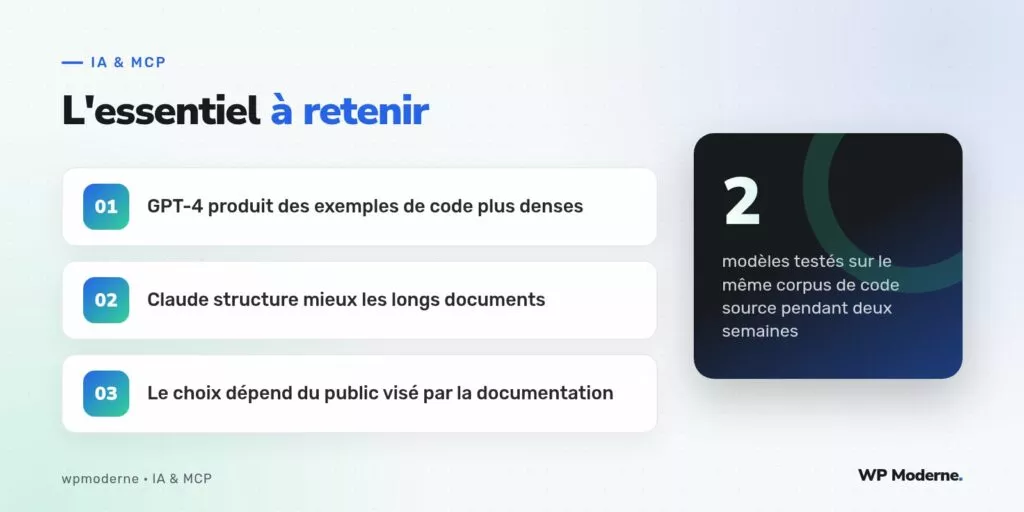
Le test s’est étalé sur deux semaines, avec une relecture croisée entre les développeurs de l’équipe pour évaluer, sans biais de préférence initiale, laquelle des deux versions rendait le code plus rapidement compréhensible à un nouvel arrivant.
Ce que révèle la comparaison
| Critère | GPT-4 | Claude |
|---|---|---|
| Exemples de code générés | Nombreux, parfois redondants | Plus rares, mais mieux choisis |
| Structure d’un document long | Tendance à répéter des sections | Plan plus cohérent sur la longueur |
| Fidélité aux noms de hooks réels | Bonne, quelques approximations | Bonne, erreurs plus rares |
| Ton du texte | Plus direct, orienté action | Plus posé, orienté explication |
Deux usages différents, deux verdicts différents
Pour la documentation destinée aux développeurs internes qui cherchent rapidement un exemple d’appel à copier, l’équipe a privilégié la version produite par GPT-4, plus riche en extraits de code directement réutilisables, malgré une certaine redondance entre les sections.
Pour le guide d’architecture générale destiné aux nouveaux arrivants, document plus long et lu de bout en bout, la version de Claude a été retenue : la progression logique entre les sections facilitait une lecture linéaire, sans avoir à sauter des paragraphes redondants.
Un point commun aux deux versions
Dans les deux cas, une relecture technique complète s’est révélée nécessaire avant publication interne : plusieurs descriptions de hooks personnalisés contenaient une erreur sur le moment exact où l’action se déclenchait dans le cycle de vie du plugin, information que seul un développeur ayant écrit le code pouvait corriger avec certitude.
Le principe retenu par l’équipe technique : la documentation générée sert de premier jet structuré, jamais de version publiable sans relecture par l’auteur du code concerné.
Le coût de l’opération
Le volume de texte traité pour l’ensemble du plugin est resté modeste, l’opération représentant un coût de quelques dollars sur chaque API, largement compensé par le temps de rédaction manuelle évité, estimé à plusieurs jours pleins de travail pour un développeur senior de l’équipe.
Notre verdict
Aucun des deux modèles ne s’impose universellement : GPT-4 convient mieux à une documentation orientée exemples de code courts et actionnables, Claude à une documentation longue destinée à être lue dans l’ordre. La startup a finalement adopté les deux, chacun sur son usage, plutôt que de trancher un vainqueur unique.
L’équipe a également retenu une leçon plus générale de cet exercice : la qualité du corpus fourni en entrée pèse au moins autant que le choix du modèle sur le résultat final. Sur les fichiers PHP les mieux commentés du plugin, les deux modèles produisaient une documentation de qualité comparable ; c’est sur les fichiers les plus anciens, dépourvus de tout commentaire, que l’écart entre les deux s’est le plus nettement creusé, Claude s’en sortant mieux pour reconstituer une intention probable à partir du seul code.
Cette observation a conduit l’équipe à revoir ses propres pratiques de commentaire du code avant même de généraliser l’usage de la documentation assistée à l’ensemble de ses projets internes, un effet collatéral bienvenu que personne n’avait anticipé au lancement du test.