wp algolia index reindex --index=webinaires : cette commande, exécutée en fin de chaîne, marque l’aboutissement d’un pipeline construit pour rendre cherchable le contenu de 46 webinaires enregistrés au fil des deux dernières années, jusque-là inexploités faute de transcription. Le montage vidéo de ces enregistrements, réalisé par ailleurs, n’entre pas dans ce tutoriel.
L’objectif final : permettre à un visiteur de rechercher un mot-clé et de retrouver directement le passage précis d’un webinaire où ce sujet a été abordé, plutôt que de devoir visionner l’intégralité de l’enregistrement.
Étape 1 : extraire l’audio et transcrire
Chaque webinaire, stocké au format vidéo, a d’abord été converti en fichier audio via ffmpeg, avant transcription par un modèle spécialisé dans la reconnaissance vocale. Le résultat brut de cette étape n’est pas un simple bloc de texte : il inclut un horodatage pour chaque segment de parole, information indispensable pour la suite du pipeline.
ffmpeg -i webinaire-046.mp4 -vn -acodec libmp3lame audio-046.mp3La transcription elle-même a été lancée via un script PHP appelant l’API du modèle de reconnaissance vocale, avec récupération d’un fichier de sortie structuré en segments horodatés plutôt qu’en texte continu.
Étape 2 : découper par horodatage
Un texte de transcription brut, sans découpage, ne permet pas une recherche pertinente : indexer un webinaire d’une heure comme un seul document ne renverrait qu’un résultat unique, sans indication du passage précis concerné. Chaque segment horodaté a donc été transformé en un enregistrement Algolia distinct, avec son propre horodatage de début :
{
  "objectID": "webinaire-046-segment-12",
  "webinaire_id": 46,
  "titre_webinaire": "Optimiser les Core Web Vitals sur WooCommerce",
  "horodatage_debut": 742,
  "texte": "Le score INP mesure desormais la reactivite percue par l'utilisateur, contrairement au FID qu'il remplace progressivement.",
  "url_lecture": "https://exemple.fr/webinaires/46?t=742"
}
Le champ url_lecture, pointant directement vers l’instant précis de la vidéo grâce à un paramètre de temps, permet à un résultat de recherche de renvoyer l’internaute exactement au bon endroit, sans qu’il ait à chercher manuellement dans l’enregistrement.
Étape 3 : indexer le lot sur Algolia
L’envoi vers Algolia s’est fait par lot de 1 000 segments via l’API d’indexation, avec un index dédié webinaires distinct de l’index principal du site, pour ne pas polluer les résultats de recherche classiques avec des extraits audio :
$index = $client->initIndex( 'webinaires' );
$index->saveObjects( $segments_a_indexer, array(
    'autoGenerateObjectIDIfNotExist' => false,
) );
Une facette a été ajoutée sur le champ titre_webinaire, permettant de filtrer les résultats par webinaire d’origine sans avoir à multiplier les index distincts.
Ce qui a demandé le plus d’ajustements
- La longueur des segments : trop courts, ils perdaient leur sens hors contexte ; trop longs, ils rendaient la recherche imprécise. Un segment de 30 à 45 secondes s’est révélé le bon compromis.
- Les erreurs de transcription sur les termes techniques anglophones, corrigées via un dictionnaire de remplacement appliqué après transcription.
- Le poids du lot complet sur l’index Algolia, qui a nécessité une répartition en plusieurs envois plutôt qu’un seul appel massif.
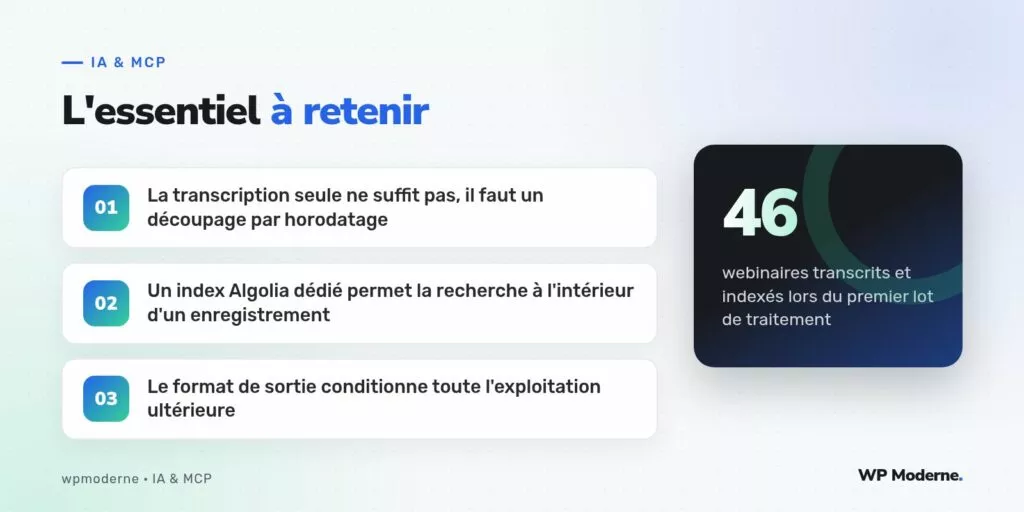
Un webinaire transcrit sans découpage par horodatage reste un webinaire invisible pour la recherche : c’est le découpage, pas la transcription elle-même, qui rend le contenu réellement exploitable.
Pour aller plus loin
Sur les 46 webinaires traités lors de ce premier lot, la recherche interne a immédiatement montré des requêtes portant sur des sujets abordés uniquement à l’oral, jamais couverts par un article écrit du site. Ce pipeline ouvre la voie à un enrichissement futur du contenu écrit à partir de ces zones de recherche jusque-là sans réponse.
Le prochain lot prévu portera sur les webinaires plus anciens, dont certains dépassent les deux heures d’enregistrement et poseront probablement de nouveaux défis de découpage : à cette durée, le nombre de segments horodatés à générer et indexer dépasse largement celui traité jusqu’ici, ce qui obligera sans doute à revoir la taille des lots envoyés à Algolia pour rester dans les limites d’un envoi raisonnable.