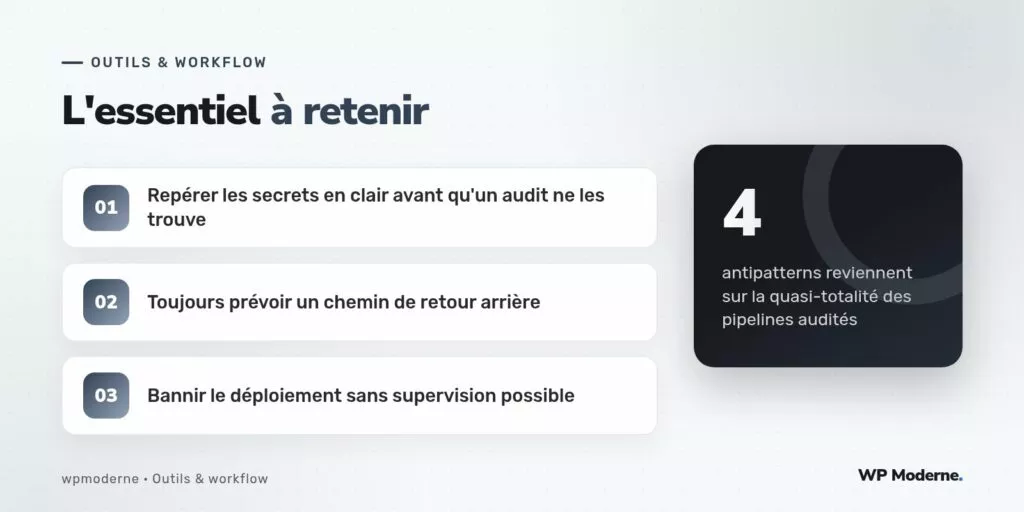
Reprendre un pipeline de déploiement conçu par une autre équipe ressemble souvent à une archéologie technique : les scripts fonctionnent, personne ne sait totalement pourquoi, et chaque tentative de modification révèle une dépendance cachée. Sur les pipelines d’agence que nous avons repris ces derniers mois, les mêmes quatre erreurs reviennent presque systématiquement.
Antipattern 1 : les secrets en clair dans le dépôt
Ce qu’on voit : un fichier de configuration versionné contenant un mot de passe de base de données, une clé d’API ou un jeton d’accès, parfois « temporairement » commenté avec l’intention de le retirer plus tard — intention rarement suivie d’effet.
Pourquoi c’est un problème : l’historique Git conserve ce secret indéfiniment, même après suppression du fichier dans un commit ultérieur. Toute personne ayant eu accès au dépôt à un moment donné, y compris un ancien stagiaire ou un prestataire externe, a potentiellement encore accès à ce secret.
Quoi faire : extraire tous les secrets dans un gestionnaire dédié ou dans des variables d’environnement injectées au moment du déploiement, puis purger l’historique Git des occurrences trouvées avec un outil comme git filter-repo, et régénérer systématiquement chaque secret exposé, sans exception.
Antipattern 2 : l’absence de chemin de retour arrière
Ce qu’on voit : un script de déploiement qui écrase directement les fichiers de production, sans conserver la version précédente, ni de mécanisme pour revenir en arrière rapidement en cas de problème détecté après coup.
Pourquoi c’est un problème : un bug découvert dix minutes après un déploiement oblige alors à corriger en urgence en production, sous pression, plutôt que de simplement revenir à la version stable précédente le temps de corriger sereinement.
Quoi faire : conserver les N dernières versions déployées dans des répertoires horodatés, avec un lien symbolique pointant vers la version active, selon un schéma simple :
/var/www/client-a/
├── releases/
│   ├── 2021-08-15_1420/
│   ├── 2021-08-20_0930/
│   └── 2021-08-22_1350/
└── courant -> releases/2021-08-22_1350/
Revenir en arrière devient alors une simple mise à jour du lien symbolique, exécutable en quelques secondes, sans redéploiement complet.
Antipattern 3 : le déploiement du vendredi en fin de journée
Ce qu’on voit : une mise en production planifiée un vendredi après 17 heures, souvent pour « ne pas déranger » le client en pleine semaine, sans que personne ne reste disponible pour surveiller le comportement du site dans les heures suivantes.
Pourquoi c’est un problème : un incident détecté le samedi matin par un visiteur du site, sans personne d’astreinte pour intervenir avant le lundi, transforme un correctif de dix minutes en un week-end de site cassé et de client mécontent.
Quoi faire : réserver les déploiements risqués — changement de version majeure, migration de base de données — à des créneaux où une personne reste disponible dans les heures suivantes, quel que soit le jour de la semaine. Un déploiement mineur et réversible peut, lui, avoir lieu n’importe quand grâce au chemin de retour arrière décrit plus haut.
Antipattern 4 : aucune notification en cas d’échec
Ce qu’on voit : une pipeline qui échoue silencieusement, visible uniquement si quelqu’un pense à consulter l’interface de la CI par curiosité.
Pourquoi c’est un problème : un déploiement échoué et non détecté laisse le site en état intermédiaire, parfois partiellement mis à jour, sans que personne ne s’en aperçoive avant qu’un utilisateur ne signale un problème.
Quoi faire : ajouter systématiquement une notification (Slack, e-mail) déclenchée en cas d’échec d’une étape de la pipeline, avec un lien direct vers les journaux du job concerné.
| Antipattern | Correctif |
|---|---|
| Secrets en clair | Gestionnaire de secrets + purge de l’historique |
| Pas de rollback | Répertoires versionnés + lien symbolique |
| Déploiement vendredi soir | Créneaux avec astreinte disponible |
| Pas de notification d’échec | Alerte automatique vers un canal surveillé |
Un pipeline qui fonctionne n’est pas forcément un pipeline sûr : ces deux qualités ne se recoupent pas toujours.
Notre verdict
Ces quatre antipatterns ne relèvent pas d’un manque de compétence technique de l’équipe qui les a mis en place, mais plutôt d’un pipeline construit dans l’urgence d’un premier projet, jamais revisité ensuite. Les corriger un par un, sans tout reconstruire d’un coup, reste la méthode la plus réaliste pour une agence qui doit continuer à livrer pendant la remise à niveau.