Est-ce qu’un conteneur qui répond « Up 3 hours » dans docker ps est réellement en train de servir des pages correctement ? La réponse est non par défaut : cette colonne indique seulement que le processus principal du conteneur n’a pas terminé, pas que le service qu’il porte fonctionne.
Cette distinction est passée inaperçue pendant plusieurs mois sur un projet WordPress conteneurisé, jusqu’au jour où PHP-FPM s’est retrouvé bloqué par un nombre de connexions à la base de données dépassant sa limite configurée. Le processus PHP-FPM continuait de tourner, Docker le considérait donc comme sain, mais chaque requête HTTP entrante restait en attente jusqu’au délai d’expiration du serveur web en amont. Rien dans l’état du conteneur ne signalait le problème.
La différence entre un processus vivant et un service qui répond
Sans directive HEALTHCHECK explicite, Docker considère un conteneur comme sain tant que son processus principal n’a pas quitté. Un conteneur PHP-FPM peut ainsi rester « en cours d’exécution » indéfiniment alors même qu’il n’accepte plus aucune nouvelle connexion, parce que son pool de workers est saturé ou bloqué sur une ressource externe. Le symptôme visible côté utilisateur — une page qui ne charge jamais — n’a donc aucune traduction dans l’état Docker du conteneur, et aucune supervision basée uniquement sur cet état ne le détectera.
Un contrôle de santé pertinent doit donc vérifier le comportement réel du service, pas seulement la présence du processus qui le porte. Pour un service HTTP, cela signifie émettre une requête et vérifier le code de retour, pas simplement interroger l’état du système.
Écrire un contrôle de santé fondé sur une requête réelle
La directive HEALTHCHECK d’un Dockerfile, ou son équivalent healthcheck dans docker-compose.yml, accepte n’importe quelle commande dont le code de sortie détermine l’état du conteneur. Pour un site WordPress servi par PHP-FPM derrière Nginx, une requête vers un point d’entrée léger et dédié convient mieux qu’une requête vers la page d’accueil complète :
healthcheck:
  test: ["CMD", "curl", "-f", "http://localhost/wp-json"]
  interval: 30s
  timeout: 5s
  retries: 3
  start_period: 20s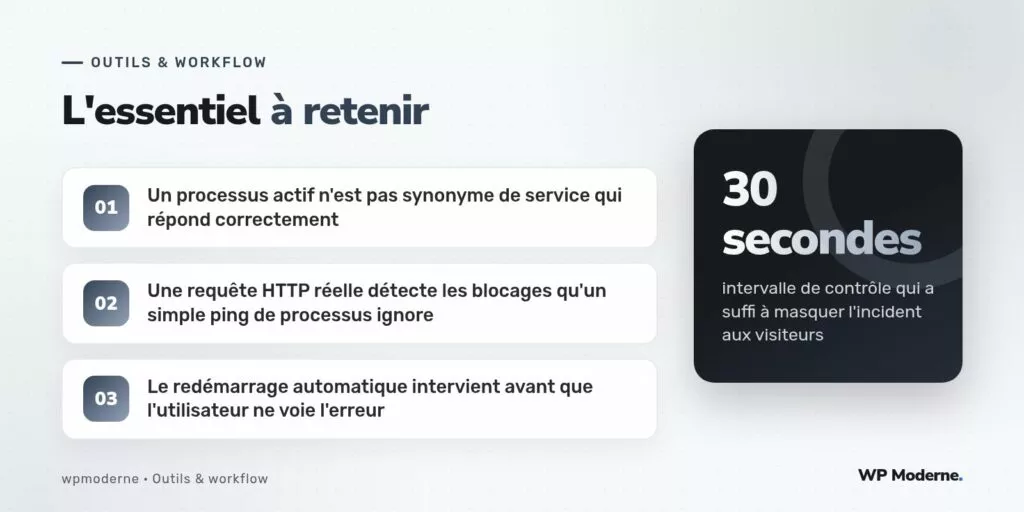
Le point d’entrée /wp-json a l’avantage de solliciter à la fois le serveur web, PHP-FPM et, indirectement, la connexion à la base de données via l’API REST de WordPress, ce qui en fait un indicateur plus fidèle qu’une simple page statique mise en cache. Le paramètre start_period évite de déclarer le conteneur défaillant pendant sa phase de démarrage, avant que PHP-FPM n’ait fini de charger.
Ce que le redémarrage automatique change concrètement
Associé à une politique de redémarrage, ce contrôle transforme un incident silencieux en incident résolu automatiquement :
restart: on-failureourestart: unless-stoppeddans la configuration du service- Trois échecs consécutifs du contrôle, soit environ 90 secondes dans l’exemple ci-dessus, avant que Docker ne marque le conteneur comme
unhealthy - Un orchestrateur externe (ou Docker lui-même selon la configuration) qui relance le conteneur dès ce marquage
Sur le cas qui a motivé cette mise en place, le blocage de PHP-FPM se reproduisait environ une fois par semaine, toujours en dehors des heures ouvrées, et n’était détecté que par un client qui rapportait une page blanche persistante le lendemain matin. Avec le contrôle de santé actif, le conteneur s’est redémarré de façon autonome trois fois en un mois, sans qu’aucun utilisateur ne rencontre d’erreur visible.
Choisir le bon point d’entrée à interroger
Le choix du point interrogé par le contrôle de santé mérite réflexion. Interroger la page d’accueil complète sollicite tout le rendu WordPress, y compris les extensions les plus lourdes, ce qui peut donner de faux positifs sous forte charge légitime. Un point d’entrée plus léger, voire un fichier PHP dédié qui se contente d’ouvrir une connexion à la base de données et de répondre 200 OK, réduit ce risque tout en restant représentatif de l’état réel du service.
Les limites de cette mise en place
Ce contrôle vérifie la santé d’un conteneur isolé ; il ne remplace pas une supervision d’ensemble sur un parc de plusieurs serveurs, qui suppose des outils de collecte et d’alerte centralisés. Il ne dit rien non plus de la cause du blocage initial, seulement de sa conséquence : un service qui ne répond plus. Le diagnostic de la cause racine, ici la saturation des connexions MySQL, a nécessité une analyse séparée des journaux applicatifs.
En résumé
Une directive HEALTHCHECK fondée sur une requête HTTP réelle coûte quelques lignes de configuration et transforme un incident silencieux, découvert par un client, en incident résolu automatiquement avant que quiconque ne s’en aperçoive. Le principe se généralise à tout service qui peut se figer sans que son processus ne se termine : la question à se poser n’est jamais « le processus tourne-t-il ? » mais « le service répond-il correctement ? ».