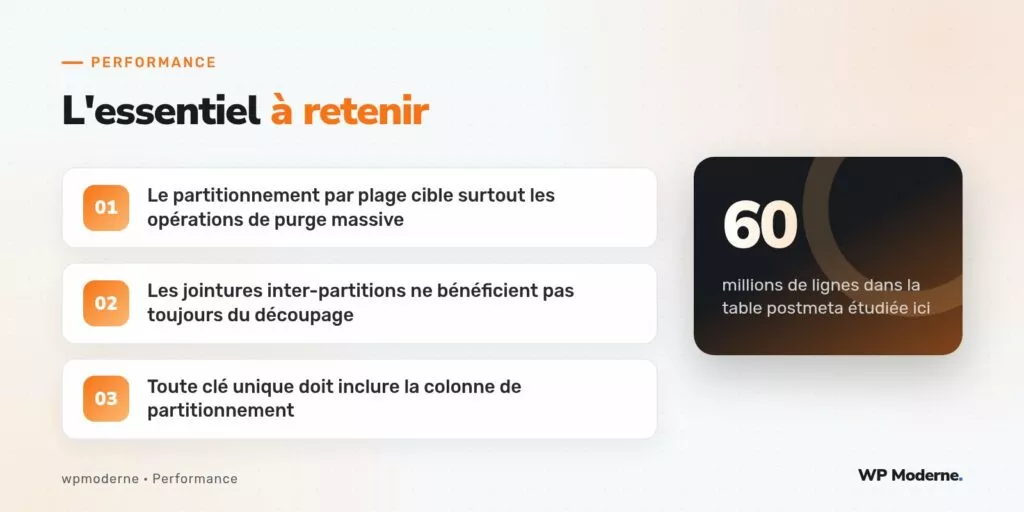
60 millions de lignes dans wp_postmeta : c’est le volume atteint sur ce projet après plusieurs années de croissance, un site de gestion documentaire interne où chaque document génère une vingtaine d’entrées de métadonnées. Le partitionnement par plage a été envisagé pour soulager les opérations de maintenance devenues très lentes, notamment la purge des métadonnées liées à des documents archivés.
Le partitionnement MySQL consiste à découper physiquement une table en plusieurs segments (partitions) selon une règle définie sur une colonne, ici la colonne post_id, en gardant une seule table logique du point de vue de WordPress. Chaque partition est stockée et indexée séparément, ce qui permet notamment de supprimer un lot entier de données en supprimant simplement une partition, une opération bien plus rapide qu’un DELETE classique sur des millions de lignes.
Structure retenue pour ce projet
ALTER TABLE wp_postmeta
PARTITION BY RANGE (post_id) (
    PARTITION p0 VALUES LESS THAN (2000000),
    PARTITION p1 VALUES LESS THAN (4000000),
    PARTITION p2 VALUES LESS THAN (6000000),
    PARTITION p_futur VALUES LESS THAN MAXVALUE
);
Cette répartition par tranches d’identifiants d’articles permettait, sur ce projet précis, de faire correspondre approximativement les partitions à des périodes de création des documents, puisque les identifiants de wp_posts croissent globalement avec le temps.
Ce que le partitionnement a réellement amélioré
L’opération de purge des métadonnées liées aux documents archivés, auparavant un DELETE massif qui verrouillait la table plusieurs minutes, a pu être remplacée par une opération ALTER TABLE ... DROP PARTITION ciblée, exécutée en quelques secondes une fois les identifiants concernés bien isolés dans une partition dédiée.
Ce que le partitionnement n’a pas amélioré
Les requêtes de lecture courantes générées par WP_Query, qui filtrent sur meta_key et meta_value sans connaître à l’avance l’identifiant d’article concerné, n’ont montré aucune amélioration mesurable : elles doivent parcourir chaque partition potentiellement concernée, ce qui annule l’avantage du découpage pour ce type d’accès.
La contrainte qui a le plus surpris l’équipe
MySQL impose que toute clé unique d’une table partitionnée inclue la colonne servant au partitionnement. La clé primaire existante de wp_postmeta, basée sur meta_id seul, a dû être recomposée pour inclure post_id, ce qui a nécessité une revue complète du code personnalisé qui s’appuyait directement sur cette clé primaire dans quelques requêtes maison.
Arborescence des risques identifiés avant la mise en production
Partitionnement wp_postmeta
├── Purge par lot
│   └── Gain net, opération devenue quasi instantanée
├── Lecture meta_query classique
│   └── Aucun gain, parcours de plusieurs partitions inchangé
├── Clé primaire
│   └── Risque : recomposition nécessaire, code legacy à auditer
└── Sauvegardes mysqldump
    └── Risque : options spécifiques nécessaires pour préserver les partitions
Recommandation retenue
Le partitionnement n’a été jugé pertinent que parce que le vrai goulot d’étranglement de ce projet était la purge périodique, pas la lecture courante. Sur un site où la lecture de métadonnées domine largement les opérations de suppression massive, un index composite bien choisi apporte généralement plus de bénéfice, pour un risque opérationnel bien moindre.
Ce qu’il faut vérifier avant toute mise en production
- La version de MySQL utilisée doit prendre en charge le partitionnement natif d’InnoDB sans limitation, ce qui est le cas des versions courantes utilisées sur un hébergement récent.
- La stratégie de sauvegarde doit être testée explicitement sur une copie partitionnée, certains outils graphiques d’administration affichant les partitions de façon incomplète si l’export n’est pas paramétré correctement.
- Tout script personnalisé qui construit des requêtes SQL brutes sur
wp_postmeta, en dehors de l’API WordPress standard, doit être audité pour vérifier sa compatibilité avec la nouvelle clé primaire composée.
Sur ce projet, cet audit a révélé deux scripts de maintenance internes qui supposaient une clé primaire à colonne unique, corrigés avant la bascule en production plutôt qu’après, ce qui a évité un incident lors du premier cycle de purge automatisée.
En résumé
Le partitionnement par plage d’une table de métadonnées géante résout un problème précis — la purge massive — sans améliorer les lectures courantes, et en ajoutant une contrainte structurelle sur les clés uniques qui peut casser du code existant. Avant de s’y engager, il vaut mieux avoir identifié précisément quelle opération pose problème, plutôt que d’espérer un gain général et diffus.