Un annuaire de santé qui recense cent cinquante mille fiches praticiens ne se met pas à jour fiche par fiche : il repose sur un import en masse, généralement un fichier ZIP contenant des photos et des documents justificatifs associés à chaque praticien, dont le nom de fichier suit une convention décidée par l’organisme partenaire qui fournit les données. C’est précisément cette convention de nommage, censée simplifier le rapprochement automatique, qui a ouvert la faille examinée ici.
Le module d’import associait chaque fichier du ZIP à une fiche praticien en se basant sur un identifiant contenu dans le nom de fichier lui-même, extrait puis utilisé pour construire le chemin de destination sur le serveur. Une analyse défensive du code, menée après un signalement de comportement anormal lors d’un import, a permis de comprendre comment ce mécanisme pouvait être détourné et comment il a été corrigé sans casser la compatibilité avec les imports existants.
Comment le nom de fichier devenait un chemin arbitraire
La fonction d’import extrayait chaque fichier du ZIP et construisait le chemin de destination directement à partir du nom fourni dans l’archive :
foreach ( $zip->get_files() as $nom_fichier ) {
    $destination = WP_CONTENT_DIR . '/uploads/praticiens/' . $nom_fichier;
    copy( $zip->extract( $nom_fichier ), $destination );
}
Rien dans ce code n’empêchait un nom de fichier contenant des séquences comme ../../ de faire remonter le chemin de destination en dehors du répertoire uploads/praticiens/. Un ZIP conçu avec un nom de fichier du type ../../../wp-config-backup.php aurait pu écrire un fichier bien au-delà du répertoire d’upload prévu, potentiellement dans une zone accessible publiquement ou exécutable par le serveur.
Pourquoi basename() seul rassure à tort
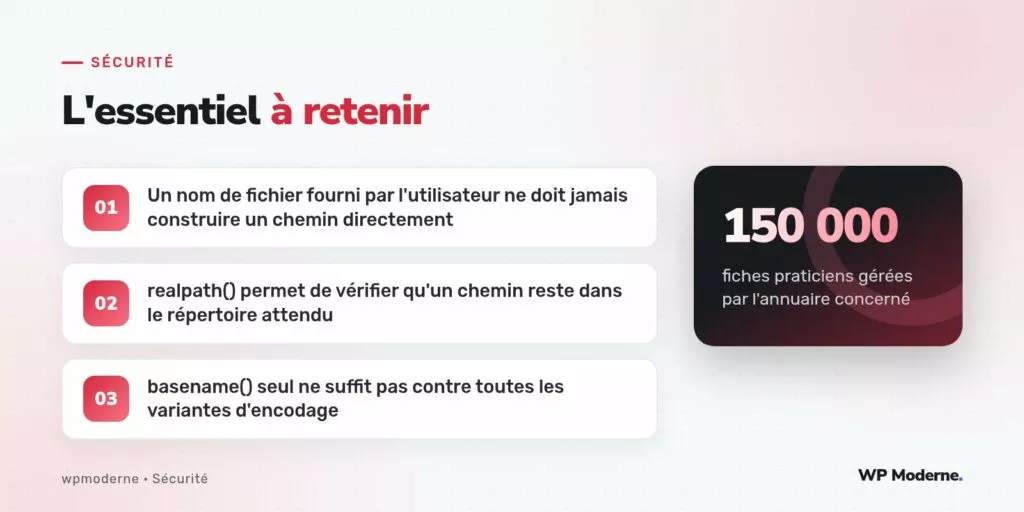
Le premier réflexe de correction, souvent insuffisant, consiste à appliquer basename() sur le nom de fichier pour n’en garder que le dernier segment :
$nom_fichier = basename( $nom_fichier ); // insuffisant seulbasename() retire effectivement les séquences ../ classiques, mais certaines variantes d’encodage ou certains systèmes de fichiers peuvent introduire des ambiguïtés que cette seule fonction ne couvre pas de façon garantie selon le contexte d’exécution. La vérification la plus robuste consiste à valider le chemin final réellement résolu, après construction complète, plutôt que de faire confiance au seul nettoyage de la chaîne d’entrée.
La validation par realpath() qui a été retenue
function importer_fichier_praticien( $nom_fichier, $source_temporaire ) {
    $repertoire_autorise = realpath( WP_CONTENT_DIR . '/uploads/praticiens' );
    $nom_nettoye         = basename( $nom_fichier );
    $destination         = $repertoire_autorise . '/' . $nom_nettoye;

    // Copie d'abord, puis vérification du chemin réellement obtenu
    copy( $source_temporaire, $destination );
    $chemin_reel = realpath( $destination );

    if ( false === $chemin_reel || 0 !== strpos( $chemin_reel, $repertoire_autorise ) ) {
        unlink( $destination );
        return new WP_Error( 'chemin_invalide', 'Nom de fichier rejeté après vérification.' );
    }
    return $chemin_reel;
}
realpath() résout les liens symboliques et les segments .. pour renvoyer le chemin absolu réel du fichier une fois écrit. En comparant ce chemin résolu au préfixe du répertoire autorisé avec strpos(), l’import peut détecter et annuler toute tentative d’écriture en dehors de la zone prévue, quelle que soit la façon dont le nom de fichier malveillant avait été construit.
Étendre la validation à l’extension et au type MIME
Le chemin n’est qu’une partie du problème sur un import de fichiers. L’audit a complété la correction avec deux vérifications supplémentaires, indispensables sur ce type de module :
- Une liste blanche d’extensions autorisées (
.jpg,.png,.pdf), rejetant tout le reste avant même la copie du fichier. - Une vérification du type MIME réel du contenu via
wp_check_filetype_and_ext(), plutôt qu’une confiance aveugle en l’extension déclarée dans le nom de fichier.
Un fichier nommé photo.jpg qui contient en réalité du code PHP exécutable reste un risque même une fois le path traversal corrigé ; les deux vérifications sont complémentaires et non substituables l’une à l’autre.
Rejouer les imports historiques après correctif
Une fois la correction déployée, l’équipe a rejoué l’historique des imports des six derniers mois sur un environnement de test isolé, pour vérifier qu’aucun nom de fichier suspect n’était passé inaperçu par le passé. Aucune trace d’exploitation réelle n’a été trouvée, mais l’exercice a confirmé que la convention de nommage fournie par l’organisme partenaire ne garantissait strictement rien côté sécurité et devait être traitée comme une donnée non fiable, au même titre qu’une saisie utilisateur classique.
Un nom de fichier qui arrive d’un système externe reste une entrée utilisateur, même quand il provient d’un partenaire de confiance : la confiance porte sur l’intention, pas sur le format des données transmises.
En résumé
Le path traversal reste l’une des vulnérabilités les plus anciennes du développement web, et pourtant elle réapparaît régulièrement dans des modules d’import qui semblent n’avoir rien à voir avec la manipulation directe de fichiers. Toute fonctionnalité qui construit un chemin sur disque à partir d’une donnée fournie de l’extérieur, même indirectement via un fichier ZIP, mérite une vérification du chemin réellement résolu, pas seulement un nettoyage de la chaîne d’entrée.



