Un rapport d’erreur peut-il, à lui seul, constituer une violation de données de santé ? La question se pose sérieusement dès qu’un outil de suivi d’erreurs comme Sentry est installé sur un site où transitent des formulaires de prise de rendez-vous médical, des questionnaires de santé ou des échanges avec un service de téléconsultation.
La réponse est oui, et c’est justement ce qui s’est produit sur un projet de plateforme de prise de rendez-vous pour un réseau de cabinets médicaux : un rapport d’erreur généré par une exception PHP mal gérée contenait, dans son contexte, le contenu intégral d’un formulaire incluant le motif de consultation saisi par le patient.
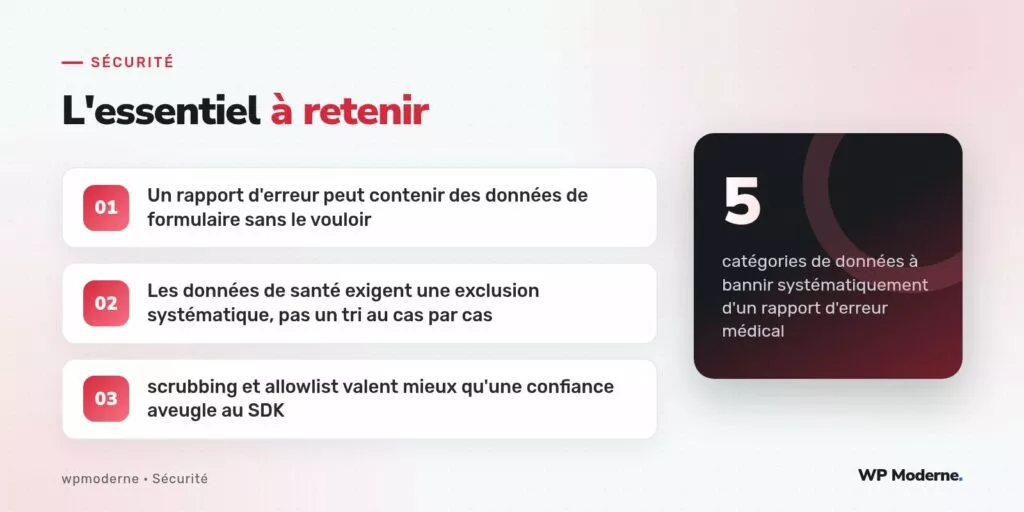
Cinq catégories de données à bannir systématiquement
Avant toute question d’hébergement du service de monitoring ou de localisation de ses serveurs, une checklist de contenu doit s’appliquer à chaque rapport d’erreur généré sur un site médical :
- Le contenu des formulaires de santé : motif de consultation, symptômes déclarés, antécédents, jamais transmis même en cas d’erreur de traitement du formulaire.
- Les identifiants de sécurité sociale ou assimilés : numéro de sécurité sociale, numéro de carte Vitale, identifiant patient interne, à traiter comme un secret au même titre qu’un mot de passe.
- Les en-têtes d’authentification et cookies de session : un jeton de session capturé dans un rapport d’erreur permet potentiellement d’usurper la session d’un patient connecté à son espace personnel.
- Les adresses e-mail et numéros de téléphone en clair associés à un contexte de santé, qui deviennent des données sensibles par association plutôt que par nature.
- Les paramètres de requête contenant des identifiants de rendez-vous, qui peuvent permettre de reconstituer un historique de consultation si combinés à d’autres informations du rapport.
Pourquoi le SDK ne fait pas ce tri tout seul
Le SDK PHP de Sentry, comme la plupart des outils de monitoring, capture par défaut un contexte large autour de chaque erreur : superglobales, en-têtes de requête, parfois le corps de la requête selon la configuration. Cette largeur de capture est un choix délibéré des éditeurs, pensé pour maximiser l’utilité diagnostique de chaque rapport, pas pour anticiper les contraintes spécifiques d’un secteur régulé comme la santé.
Deux stratégies complémentaires : scrubbing et allowlist
Le scrubbing consiste à définir des motifs de champs à exclure automatiquement, par nom (motif_consultation, numero_secu) ou par expression régulière détectant un format connu (numéro de sécurité sociale à quinze chiffres, par exemple). Cette approche protège contre l’oubli, mais dépend de la qualité et de l’exhaustivité de la liste de motifs définie.
L’allowlist inverse la logique : plutôt que d’exclure ce qui est connu comme sensible, elle n’autorise que les champs explicitement validés comme sûrs à transmettre, tout le reste étant supprimé par défaut. Cette seconde approche est plus contraignante à mettre en place, mais elle protège aussi contre les champs sensibles qui n’auraient pas été anticipés lors de la rédaction de la liste d’exclusion.
Sur un projet manipulant des données de santé, la combinaison des deux est recommandée : une allowlist stricte sur le contexte applicatif personnalisé ajouté par le code, complétée par un scrubbing sur les données capturées automatiquement par le SDK (en-têtes, cookies, superglobales).
Vérifier avant, pas après un audit
La vérification la plus fiable reste manuelle : provoquer volontairement plusieurs types d’erreurs représentatives (exception dans un formulaire de prise de rendez-vous, erreur de connexion à la base de données, erreur d’API tierce) et inspecter chaque rapport généré dans le tableau de bord Sentry, champ par champ, avant la mise en production. Cette vérification devrait être documentée et conservée comme preuve de diligence, utile en cas de contrôle par une autorité de protection des données.
En résumé
Sur un projet manipulant des données de santé, la question de l’hébergement d’un outil de monitoring vient après celle du contenu qu’il capture, jamais avant. Une checklist de scrubbing appliquée systématiquement, doublée d’une vérification manuelle documentée, réduit le risque à un niveau raisonnable sans renoncer aux bénéfices réels d’un suivi d’erreurs bien configuré.



