« Découverte – actuellement non indexée. » « Explorée, actuellement non indexée. » Ces deux libellés du rapport Couverture de Search Console sèment la confusion chez beaucoup de développeurs, parce qu’ils laissent croire à un problème d’accès. Or Google a bien lu la page : il a simplement choisi de ne pas la garder dans son index. C’est une décision qualitative, pas un blocage technique.
Sur WordPress, ce statut touche massivement certains types de contenus : archives d’étiquettes peu fournies, pages de résultats de recherche interne, fiches produits variantes, ou articles publiés en rafale sans réel apport. Comprendre pourquoi Google écarte ces pages permet d’agir sur les bons leviers plutôt que de re-soumettre inutilement les URL une à une.
Ce que « currently not indexed » signifie vraiment
Le mot-clé est « currently ». Google indique explicitement que la situation n’est pas définitive : la page a été explorée (ou programmée pour l’être), analysée, puis laissée de côté au moment de la décision d’indexation. Elle peut basculer en indexée plus tard, sans aucune intervention, si son contexte change — un lien interne supplémentaire, une mise à jour du contenu, une baisse de la concurrence sur le même sujet.
Cette distinction change la façon de prioriser un audit. Une page en erreur 5xx exige une correction immédiate. Une page « currently not indexed » demande d’abord un diagnostic : le contenu apporte-t-il quelque chose que Google ne trouve pas ailleurs sur le site, ou même ailleurs sur le web ?
La cause n°1 : le duplicate léger, invisible à l’œil nu
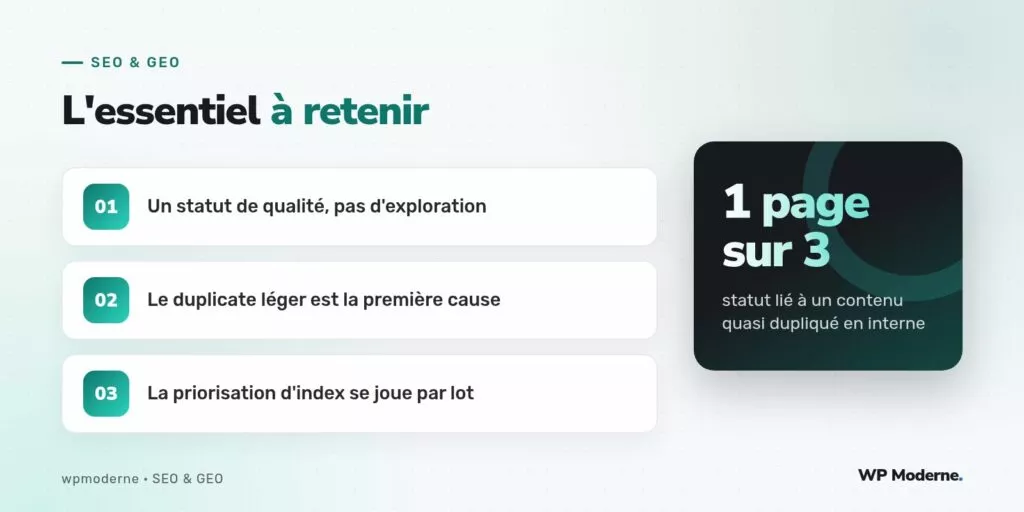
Sur les sites WordPress générés par des thèmes ou constructeurs de pages, une part importante des contenus non indexés partagent une structure quasiment identique : même introduction générique, même bloc de call-to-action, même structure de titres, avec seul le nom du produit ou de la ville qui change. Google ne parle pas ici de copie externe, mais de similarité interne au site — un signal souvent négligé.
- Fiches produits WooCommerce déclinées uniquement par couleur ou taille, avec une description commune
- Pages « ville + prestation » générées par gabarit pour du SEO local
- Articles de blog issus d’un plan éditorial trop rigide, tous bâtis sur le même squelette de paragraphes
Le correctif ne consiste pas à réécrire chaque page à la main, mais à injecter un minimum de contenu réellement différenciant : un paragraphe rédigé sur les particularités locales, un avis client spécifique, une donnée chiffrée propre à la variante.
La cause n°2 : un maillage interne qui ne vote pas pour la page
Une page peut être unique dans son contenu et rester non indexée si rien, sur le site, ne pointe vers elle avec un texte d’ancre pertinent. Google évalue l’importance relative d’une URL en partie via les liens qu’elle reçoit en interne. Une page publiée puis reléguée en page 4 d’une archive, sans lien depuis un article populaire ni depuis le menu, envoie un signal d’insignifiance.
Sur un site WordPress, cela se corrige avec des outils déjà présents : le bloc core/query pour afficher les contenus liés en bas d’article, un widget de type « articles similaires » basé sur les taxonomies, ou tout simplement un lien manuel depuis une page à forte autorité.
La cause n°3 : un budget de crawl consommé ailleurs
Sur les sites volumineux, Googlebot ne réexplore pas l’intégralité des URL à chaque passage. S’il consacre son temps à des pages de recherche interne, à des archives de dates ou à des paramètres d’URL générés par des filtres, les nouvelles pages de contenu attendent plus longtemps avant même d’être analysées pour indexation. Le rapport « Statistiques d’exploration » de Search Console, dans les paramètres du site, permet de vérifier la répartition des requêtes par type de réponse et de repérer ce gaspillage.
Un ordre de vérification pragmatique
- Vérifier dans l’outil d’inspection d’URL si la page a bien été explorée récemment
- Comparer son contenu à celui des pages similaires déjà indexées du site
- Contrôler le nombre et la qualité des liens internes qui pointent vers elle
- Regarder si le site consomme son budget de crawl sur des URL à faible valeur
Sur un audit récent, nous avons vu remonter en indexation près de la moitié des pages concernées en six semaines, simplement en ajoutant un paragraphe unique et deux liens internes qualifiés par page — sans aucune demande d’indexation manuelle.
Ce qui ne fonctionne pas
Cliquer en boucle sur « Demander une indexation » dans l’outil d’inspection n’a aucun effet structurel : la fonctionnalité déclenche une nouvelle exploration, pas une nouvelle évaluation de qualité. Répéter l’opération sur des dizaines de pages identiques dans leur structure ne change rien au diagnostic sous-jacent, et peut même consommer inutilement le quota quotidien de demandes.
De la même façon, générer un sitemap XML très complet ne suffit pas à forcer l’indexation : le sitemap sert à faire connaître l’existence d’une URL, pas à convaincre Google de sa valeur.
En résumé
« Crawled – currently not indexed » n’est ni une panne ni une pénalité : c’est un jugement, révisable, sur l’intérêt d’une page par rapport au reste du web et du site lui-même. Le travail consiste à repérer les gabarits trop répétitifs, à muscler le maillage interne des pages négligées, et à vérifier que le budget de crawl n’est pas dilapidé sur des URL sans valeur. Ce sont ces trois leviers, combinés, qui font basculer une page de « non indexée » à « indexée » — bien plus sûrement qu’une demande manuelle répétée.