Combien de mémoire vive faut-il réellement pour crawler cinquante mille URL sans que Screaming Frog ne se fige à mi-parcours ? La question se pose dès qu’on dépasse l’échelle d’un site vitrine, et la réponse par défaut du logiciel — 512 Mo alloués à la JVM — ne tient tout simplement pas la distance.
Ce guide détaille la configuration pas à pas pour auditer un site WordPress volumineux sans plantage et sans que le contenu dupliqué généré par les paramètres d’URL ne pollue les rapports.
Étape 1 : augmenter la mémoire allouée
Screaming Frog tourne sur une machine virtuelle Java dont la mémoire par défaut est bridée. Avant tout crawl de grande ampleur, il faut l’augmenter dans Configuration → System → Memory, en visant au moins 4 à 8 Go selon la RAM disponible sur la machine. Sans ce réglage, l’outil affiche un message d’avertissement mémoire bien avant d’avoir terminé les cinquante mille URL, et les résultats partiels ne sont pas fiables pour un diagnostic complet.
Basculer en mode base de données
Au-delà de quelques dizaines de milliers de pages, le mode de stockage par défaut, entièrement en mémoire vive, montre ses limites même avec un réglage généreux. Le mode « Database Storage », activé dans Configuration → System → Storage, écrit les données sur disque au fil du crawl : plus lent par requête, mais capable de tenir sur la durée sans dégrader les performances de la machine.
Étape 2 : exclure les paramètres d’URL parasites
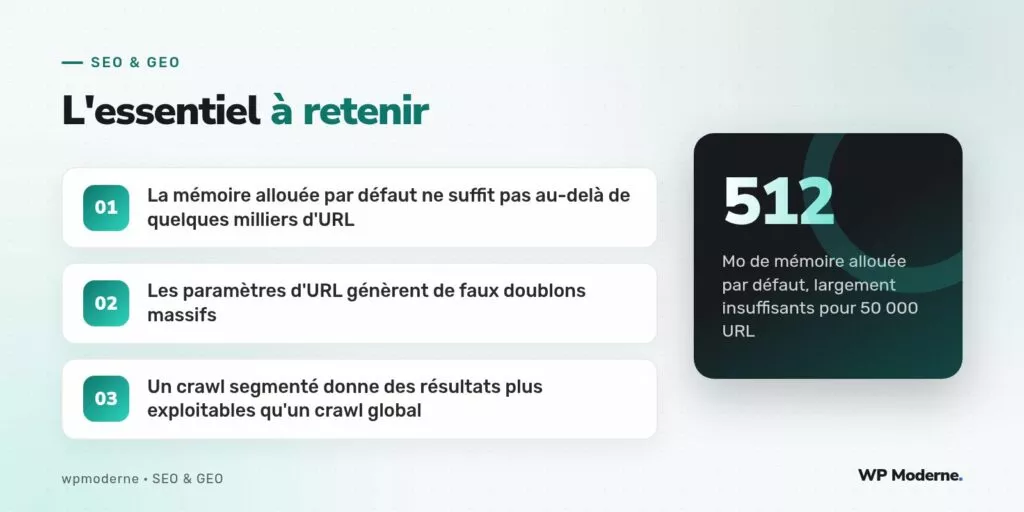
Un site WordPress avec une recherche interne, des filtres de catégorie ou un système de tri sur ses pages d’archive génère souvent des dizaines de variantes d’URL pour un même contenu : ?orderby=price, ?filter_couleur=rouge, ?s=terme. Sans exclusion, Screaming Frog les traite comme des pages distinctes, ce qui gonfle artificiellement le nombre d’URL crawlées et fausse les statistiques de contenu dupliqué.
La configuration se fait dans Configuration → Exclude, avec des expressions régulières ciblées :
.*\?orderby=.*
.*\?filter_.*=.*
.*\?s=.*
Une alternative plus fine consiste à utiliser l’onglet URL Rewriting pour supprimer certains paramètres avant crawl plutôt que de les exclure entièrement, ce qui permet de garder une trace de leur existence sans les compter en double.
Étape 3 : segmenter plutôt que tout lancer d’un bloc
Sur un site de cette taille, un crawl unique de bout en bout complique l’analyse : les rapports deviennent trop volumineux pour être lus efficacement. Il est préférable de segmenter par répertoire, en configurant Include sur des sections du site (/blog/, /produits/, /pages/) et en comparant les résultats section par section.
- Crawl 1 : uniquement les articles de blog, pour vérifier la profondeur de maillage interne.
- Crawl 2 : les pages produit ou fiches, pour repérer les titres et méta-descriptions dupliqués.
- Crawl 3 : les pages d’archive et de pagination, souvent source de contenu quasi identique.
Étape 4 : limiter la vitesse pour ne pas fausser les résultats
Un crawl trop rapide sur un hébergement mutualisé peut déclencher une protection anti-bot côté serveur, qui commence à renvoyer des pages d’erreur ou des CAPTCHA à mi-crawl. Dans Configuration → Speed, limiter le nombre de threads simultanés et fixer un délai entre requêtes évite ce faux positif qui, sinon, se traduit par des centaines de pages signalées à tort comme cassées.
Sur nos audits de gros sites WordPress, on démarre toujours par un crawl limité à 500 URL en mode rapide pour valider la configuration des exclusions, avant de lancer le crawl complet qui peut durer plusieurs heures.
Étape 5 : exporter et croiser avec le sitemap
Une fois le crawl terminé, l’export des URL découvertes doit être comparé à celui du sitemap XML généré par l’extension SEO du site. Les écarts entre les deux listes sont souvent le signal le plus utile de l’audit : des pages orphelines découvertes uniquement par le crawl, ou à l’inverse des URL du sitemap qu’aucun lien interne ne permet d’atteindre.
En résumé
Crawler cinquante mille URL avec Screaming Frog n’est pas qu’une question de patience : c’est une question de configuration mémoire, d’exclusion de paramètres et de segmentation du travail. Sans ces trois réglages, l’outil plante ou produit des rapports gonflés de faux doublons qui rendent l’audit inexploitable.