Une balise <link rel="canonical"> parfaitement présente dans le code source, pointant vers l’URL attendue, et pourtant Google classe la page sous le statut « Duplicate without user-selected canonical », comme si aucune préférence n’avait jamais été exprimée. Ce statut, distinct de la pagination, trouble souvent les développeurs qui pensaient avoir correctement réglé le problème en ajoutant simplement la balise.
Ce billet détaille les cas où Google ignore délibérément une balise canonical techniquement correcte, et comment y remédier sans se contenter de vérifier sa seule présence dans le code.
Une balise canonical n’est jamais une directive absolue
Contrairement à une balise noindex, qui constitue une instruction stricte que Google respecte systématiquement, la balise canonical n’est qu’un signal parmi d’autres. Google se réserve le droit de la contredire s’il estime que d’autres indices pointent dans une direction différente, notamment lorsque le contenu des deux pages en question n’est pas suffisamment proche pour justifier une consolidation.
Ce statut apparaît typiquement lorsque deux URL déclarées comme canonical l’une vers l’autre présentent en réalité un contenu qui diverge sur des points que Google juge significatifs : un produit décliné en plusieurs couleurs avec des descriptions partiellement réécrites, par exemple, peut ne pas être considéré comme suffisamment dupliqué pour justifier une seule URL canonique.
Les signaux contradictoires qui invalident la balise
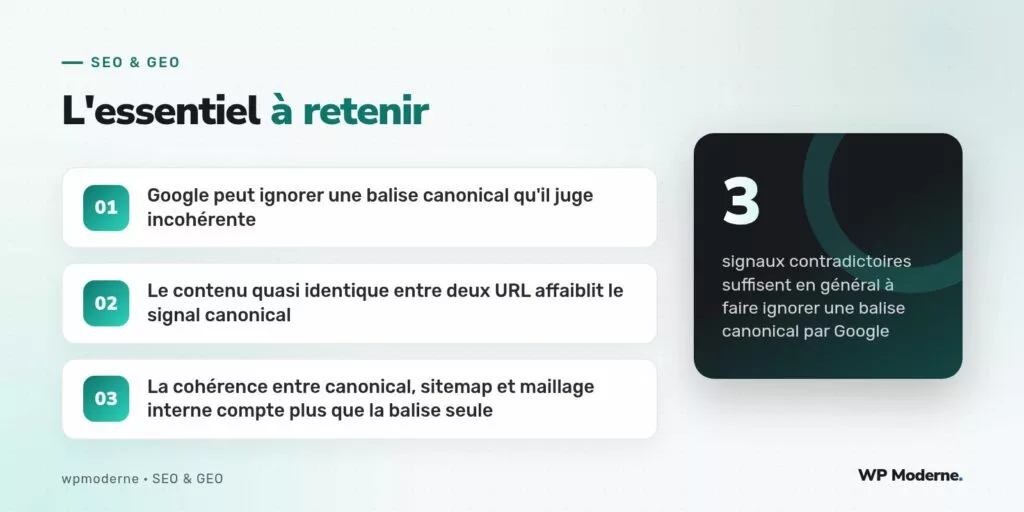
Plusieurs incohérences reviennent fréquemment dans ce diagnostic. La première : la page non canonique reçoit davantage de liens internes que la page désignée comme canonique, ce qui envoie à Google un signal d’importance contradictoire avec la déclaration explicite dans le code.
La deuxième : le sitemap XML référence les deux URL indistinctement, sans exclure celle qui devrait pourtant s’effacer au profit de sa version canonique. Un sitemap qui contredit les balises canonical du site affaiblit la cohérence globale du signal envoyé à Google.
La troisième, plus subtile : la page non canonique a accumulé un historique d’indexation et de liens externes bien antérieur à celui de la page désignée comme canonique, ce qui pousse parfois Google à conserver l’ancienne URL comme référence par défaut, indépendamment de la préférence explicite du site.
Corriger en agissant sur l’ensemble des signaux
La correction ne se limite jamais à la balise elle-même :
- Retirer l’URL non canonique du sitemap XML, pour ne conserver que la version que l’on souhaite voir indexée.
- Réorienter le maillage interne existant vers la version canonique désignée, en corrigeant les liens qui pointent encore vers l’ancienne URL.
- Si l’écart de contenu entre les deux pages est réellement significatif, reconsidérer s’il s’agit vraiment d’un doublon ou de deux pages qui méritent chacune leur propre indexation distincte.
Quand le contenu n’est pas assez proche
Il arrive que ce statut révèle en réalité une erreur de conception plutôt qu’un problème d’exploration : deux pages traitées comme des doublons alors qu’elles répondent en réalité à des intentions de recherche différentes ne devraient tout simplement pas partager de balise canonical. Dans ce cas, la correction consiste à retirer la balise canonical incorrecte et à laisser chaque page s’indexer indépendamment, en s’assurant que leur contenu respectif est suffisamment développé et distinct pour le justifier.
Avant de corriger une balise canonical ignorée, on se pose toujours la question inverse : et si Google avait raison de l’ignorer ? Il arrive plus souvent qu’on ne le pense que la déclaration initiale reposait sur une hypothèse de duplication qui ne tenait pas la route.
En résumé
Ce statut n’indique pas un problème technique de balisage à proprement parler, mais une incohérence entre la préférence déclarée et les signaux réels perçus par Google : maillage interne, sitemap, historique d’indexation. La correction efficace agit sur l’ensemble de ces signaux, jamais sur la seule balise canonical isolée du reste du contexte technique de la page.