HEAD /produit/etagere-chene-massif/ HTTP/1.1. Cette ligne, dans un journal d’accès Apache ou Nginx, correspond à une requête que beaucoup de développeurs ne testent jamais eux-mêmes, tant leur navigateur n’en émet quasiment pas. Or certains robots d’indexation et outils d’audit s’en servent délibérément avant une exploration complète, pour vérifier qu’une URL existe, qu’elle n’a pas changé depuis la dernière visite, ou qu’elle ne renvoie pas une redirection inutile.
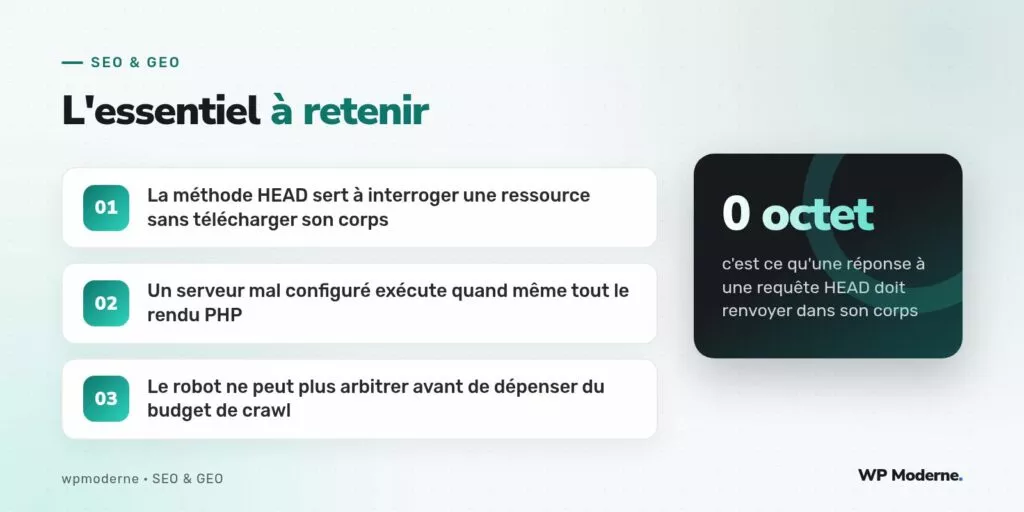
Le principe de la méthode HEAD, défini dans la spécification HTTP, est simple : le serveur doit renvoyer exactement les mêmes en-têtes qu’il aurait renvoyés pour une requête GET identique, mais sans corps de réponse. Un serveur WordPress mal configuré ignore souvent cette distinction et traite HEAD comme un simple alias de GET, en générant le corps complet de la page avant de le jeter. Le coût de calcul est payé, l’objectif d’économie de bande passante et de temps de traitement du côté du robot est perdu.
Reproduire le problème étape par étape
Voici comment vérifier, sur un site WordPress classique, si une requête HEAD déclenche ou non l’exécution complète du gabarit de page.
- Ouvrir un terminal et exécuter
curl -I -w "%{time_total}\n" https://exemple.fr/un-article/pour mesurer le temps de réponse d’une requête HEAD. - Comparer avec
curl -o /dev/null -s -w "%{time_total}\n" https://exemple.fr/un-article/, qui effectue une requête GET classique et jette le corps localement. - Si les deux temps sont quasiment identiques, c’est le signe que le serveur exécute tout le rendu PHP dans les deux cas, y compris les requêtes à la base de données et les appels aux extensions actives sur
template_redirect. - Activer un journal temporaire dans
functions.phpdu thème, sur le hooktemplate_redirect, pour confirmer que le code s’exécute même quand$_SERVER['REQUEST_METHOD']vautHEAD. - Corriger en interceptant la méthode tôt, avant tout calcul lourd.
Où intercepter la requête au plus tôt
La correction la plus fiable ne se fait pas dans WordPress mais en amont, au niveau du serveur web, qui doit répondre sans même charger PHP-FPM pour les cas les plus simples. Sur Nginx, un bloc dédié permet de renvoyer les en-têtes attendus sans invoquer le processus PHP :
location / {
    if ($request_method = HEAD) {
        add_header X-Robots-Handled "head-fast-path";
    }
    try_files $uri $uri/ /index.php?$args;
}
Cette approche reste partielle : elle ne dispense pas du calcul du code HTTP de réponse, qui dépend souvent de la logique métier (une page peut être en 404, en redirection, ou en succès). Une solution plus robuste consiste à laisser WordPress traiter la requête normalement jusqu’au moment de l’affichage, mais à couper l’exécution juste avant la génération du gabarit :
add_action( 'template_redirect', function () {
    if ( 'HEAD' === $_SERVER['REQUEST_METHOD'] ) {
        status_header( 200 );
        header( 'Content-Length: 0' );
        exit;
    }
}, 0 );
Le paramètre de priorité à 0 assure que ce court-circuit intervient avant la plupart des extensions, notamment celles qui interrogent des services distants ou effectuent des calculs coûteux au chargement de chaque page.
Ce que cela change pour le budget de crawl
Un robot qui envoie une requête HEAD avant une exploration complète le fait généralement pour prioriser : il compare la date de dernière modification ou une empreinte de contenu à ce qu’il connaît déjà, et décide s’il vaut la peine d’explorer la page en entier. Si le serveur répond avec un temps équivalent à une requête complète, cet arbitrage perd tout son intérêt : le robot paie le coût d’une page entière pour obtenir une information qu’il aurait dû obtenir presque gratuitement.
- Un site à fort volume de pages, avec beaucoup de contenus rarement modifiés, perd le bénéfice de ce filtrage précoce.
- Le temps de réponse moyen mesuré par les outils d’audit se dégrade sans qu’aucune page individuelle ne semble anormalement lente.
- Le nombre de requêtes traitées par seconde chute sur les pics de crawl, ce qui peut ralentir aussi les visiteurs humains au même moment.
Toujours tester les deux méthodes, HEAD et GET, sur les mêmes URL avant de conclure qu’un serveur est bien réglé. Une configuration optimisée uniquement pour GET laisse un angle mort que seuls les robots exploitent.
Pour aller plus loin
Cette optimisation ne remplace pas un travail de fond sur le cache de page complet, mais elle traite un cas précis souvent négligé : les visites qui ne cherchent pas de contenu, seulement une confirmation. Sur un site avec un catalogue volumineux, ce détail de configuration, une fois corrigé, redonne aux robots la possibilité de faire ce qu’ils sont censés faire depuis toujours, c’est-à-dire explorer intelligemment plutôt que systématiquement.