Pourquoi une page ajoutée dans robots.txt continue-t-elle parfois d’apparaître dans les résultats de recherche Google ? C’est une question que se posent régulièrement les développeurs qui débutent en référencement technique, et la réponse tient à une confusion très répandue entre deux mécanismes qui n’agissent pas au même endroit du processus.
D’un côté, le fichier robots.txt agit sur l’exploration (le crawl) : il indique aux robots quelles URL ils ont le droit de visiter. De l’autre, la balise meta noindex agit sur l’indexation : elle indique qu’une page, même visitée, ne doit pas apparaître dans les résultats. Ces deux étapes sont distinctes, et bloquer la première n’empêche pas forcément la seconde.
Ce que fait réellement robots.txt
Le fichier robots.txt est une simple liste de règles d’autorisation ou d’interdiction d’exploration, placée à la racine du site. Sur WordPress, son contenu par défaut est généré dynamiquement via le filtre robots_txt, que l’on peut modifier ainsi :
add_filter( 'robots_txt', function( $output, $public ) {
    $output .= "Disallow: /panier/\n";
    return $output;
}, 10, 2 );
Un robot respectueux des règles ne visitera donc jamais l’URL /panier/. Mais s’il découvre cette même URL par un lien externe, il peut connaître son existence sans jamais l’avoir explorée — et Google peut afficher cette URL dans ses résultats, sans titre ni description, avec la mention « Aucune information n’est disponible pour cette page ».
Ce que fait réellement la balise noindex
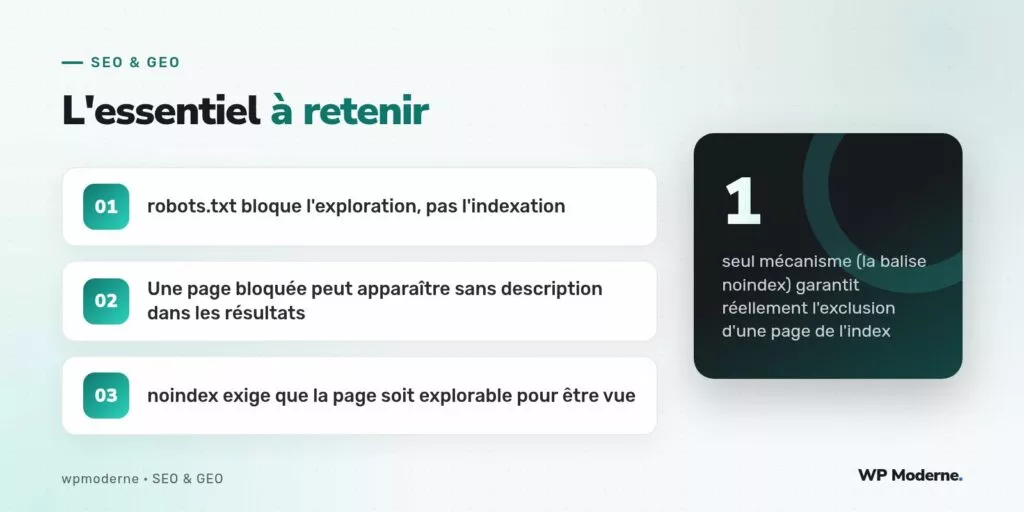
La balise meta <meta name="robots" content="noindex">, elle, est lue au moment où le robot explore effectivement la page. Elle indique explicitement de ne pas l’ajouter à l’index. C’est là que réside le piège : pour qu’un robot lise cette instruction, il doit pouvoir explorer la page. Si la page est bloquée par robots.txt, le robot ne la visite jamais et ne voit donc jamais l’instruction noindex qu’elle contient.
Sur un thème WordPress sans extension, on peut ajouter cette balise manuellement pour une page donnée via le hook wp_head :
add_action( 'wp_head', function() {
    if ( is_page( 'brouillon-interne' ) ) {
        echo '<meta name="robots" content="noindex">' . "\n";
    }
} );
Le piège concret
Un développeur junior qui veut exclure une page de l’index Google commet souvent l’erreur suivante : il ajoute la ligne Disallow: /brouillon-interne/ dans robots.txt, pensant avoir réglé le problème. Quelques semaines plus tard, la page apparaît toujours dans Google, simplement dépourvue de description. La cause : le robot ne peut plus explorer la page, donc il ne peut plus non plus lire une éventuelle balise noindex qui aurait réellement réglé le problème.
Un scénario concret rencontré en audit
Sur un site institutionnel, une section entière d’archives d’anciens communiqués avait été ajoutée à robots.txt plusieurs années auparavant, dans l’idée de « nettoyer l’index ». En reprenant l’historique du rapport de couverture, ces mêmes URL apparaissaient encore, des années plus tard, sous la mention « Indexée, bien que bloquée par le fichier robots.txt ». Autrement dit, Google savait que ces pages existaient — par des liens externes anciens — sans jamais avoir pu les explorer pour vérifier s’il fallait ou non les afficher.
La correction a consisté à retirer temporairement la règle Disallow, le temps que le robot explore chaque page et lise une balise noindex ajoutée en parallèle, avant de vérifier leur retrait effectif du rapport de couverture puis, seulement à ce moment-là, de décider si un blocage d’exploration restait utile pour économiser le budget de crawl.
La bonne méthode selon l’objectif
- Économiser le budget de crawl sur des pages sans valeur SEO (recherche interne, panier) :
robots.txt - Empêcher qu’une page apparaisse dans les résultats de recherche : balise
noindex, sans bloquer l’exploration - Retirer une page déjà indexée : d’abord laisser le robot explorer la page avec
noindex, attendre son retrait, puis seulement bloquer l’exploration si besoin
Le repère à donner à un client pressé : robots.txt ferme la porte d’entrée, noindex retire l’objet de la vitrine. Fermer la porte ne vide pas la vitrine si l’objet y était déjà.
En résumé
Confondre ces deux mécanismes conduit à des situations où une page reste visible dans les résultats de recherche malgré une tentative de blocage, ou pire, où une page qu’on croyait exclue reste indexée indéfiniment. La règle à retenir est simple : pour qu’une instruction d’indexation soit lue, la page doit rester explorable. Le blocage d’exploration et l’exclusion d’indexation sont deux outils différents, à utiliser selon un objectif précis, jamais l’un à la place de l’autre.