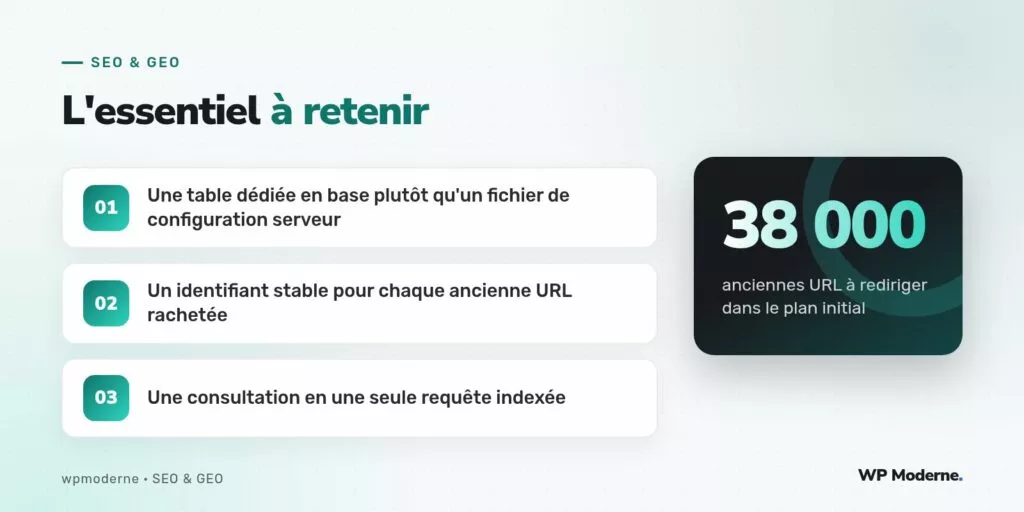
2004 à 2021 : dix-sept années d’archives, 38 000 articles publiés sous trois structures d’URL successives, pour ce titre de presse locale racheté et migré vers WordPress. Un fichier de redirections classique, qu’il s’agisse de règles Apache ou Nginx, devient rapidement ingérable à cette échelle : chaque règle supplémentaire ralentit légèrement l’analyse de la configuration à chaque requête, et la maintenance d’un fichier de plusieurs dizaines de milliers de lignes tourne vite au cauchemar pour qui doit le faire évoluer.
La solution retenue déplace la logique de redirection depuis le fichier de configuration du serveur vers une table dédiée en base de données, interrogée directement par WordPress au moment du traitement de la requête. Cet article ne traite pas du travail éditorial du repreneur sur le contenu existant, mais uniquement de l’architecture technique du plan de redirection.
Pourquoi un fichier serveur ne convient pas ici
Les trois structures d’URL successives utilisées par le titre au fil de ses refontes précédentes rendent impossible l’écriture de règles génériques simples. Certaines anciennes URL suivent un format par date, d’autres un identifiant numérique, d’autres encore un slug reconstruit après une migration antérieure ratée. Sans correspondance individuelle et stable entre chaque ancienne URL et sa nouvelle destination, aucune règle générique ne peut couvrir correctement l’ensemble des cas.
Un fichier .htaccess ou une configuration Nginx contenant 38 000 règles individuelles poserait en outre un problème de performance pur : chaque requête HTTP nécessiterait l’analyse séquentielle d’un fichier de configuration disproportionné, avec un effet mesurable sur le temps de réponse global du serveur.
Structure de la table de redirections
La table créée à cet effet, nommée wp_legacy_redirects, suit une structure volontairement simple :
CREATE TABLE wp_legacy_redirects (
    id BIGINT UNSIGNED AUTO_INCREMENT PRIMARY KEY,
    old_path VARCHAR(255) NOT NULL,
    new_url VARCHAR(255) NOT NULL,
    hits INT UNSIGNED DEFAULT 0,
    UNIQUE KEY old_path_idx (old_path)
);
La colonne old_path porte un index unique, ce qui garantit à la fois l’absence de doublon et une recherche en temps constant, indépendamment du nombre total de lignes. La colonne hits permet un suivi ultérieur : identifier les anciennes URL encore régulièrement demandées, des mois après la migration, pour prioriser d’éventuelles corrections de maillage externe.
Interception de la requête côté WordPress
L’accroche se fait sur le hook template_redirect, suffisamment tôt dans le cycle de chargement pour intercepter une requête avant que WordPress ne tente de résoudre une page inexistante et ne génère une erreur 404 :
add_action( 'template_redirect', function () {
    global $wpdb;

    $path = $wpdb->get_var(
        $wpdb->prepare(
            "SELECT new_url FROM wp_legacy_redirects WHERE old_path = %s",
            esc_url_raw( $_SERVER['REQUEST_URI'] )
        )
    );

    if ( $path ) {
        wp_safe_redirect( $path, 301 );
        exit;
    }
} );
Cette fonction ne s’exécute que lorsque WordPress s’apprête à afficher une page 404, condition ajoutée via is_404() en tête de fonction, pour ne jamais interférer avec les URL valides du nouveau site.
Organiser la reprise des données
L’import initial des 38 000 correspondances s’est fait par lots de mille lignes via wpdb::query() avec des instructions INSERT groupées, plutôt qu’une insertion ligne par ligne qui aurait multiplié inutilement les allers-retours avec le serveur de base de données.
Suivre l’efficacité du plan dans la durée
Trois mois après la mise en ligne, une requête simple sur la colonne hits, triée par ordre décroissant, permet d’identifier les cinquante anciennes URL les plus sollicitées. Ce classement guide la priorité de vérification manuelle : s’assurer que chacune redirige bien vers un contenu réellement équivalent, et non vers une page générique par défaut faute de correspondance identifiée lors de la migration.
En résumé
Pour un volume de redirections qui se compte en dizaines de milliers, une table SQL indexée bat très largement un fichier de configuration serveur, tant en performance qu’en facilité de maintenance. Cette architecture, bâtie sur un hook natif et une requête préparée classique, reste entièrement transposable à tout site WordPress hérité d’un historique d’URL fragmenté par plusieurs refontes successives.