500 Internal Server Error. Rien dans les logs applicatifs de WordPress, rien dans les journaux du plugin SEO installé, et pourtant Search Console signale des erreurs de récupération sur /wp-sitemap.xml depuis deux semaines. Le pire, dans ce genre de panne : elle ne se reproduit jamais quand on la cherche.
Ce cas concret concerne un site éditorial d’environ 40 000 contenus publiés, hébergé sur un serveur mutualisé haut de gamme, où le sitemap plantait uniquement entre 12 h et 14 h, au moment du pic de trafic quotidien. Le diagnostic a demandé de sortir des outils habituels de débogage WordPress pour aller regarder ce qui se passe côté serveur.
Symptôme : un sitemap capricieux et invisible en local
En environnement de développement, /wp-sitemap.xml répond en 200 ms, sans erreur. En production, le comportement est aléatoire : parfois 200, parfois 500, sans corrélation évidente avec un contenu particulier. Les tentatives de reproduction manuelle échouent systématiquement, ce qui écarte d’emblée une piste de contenu corrompu ou de requête SQL malformée sur un article précis.
Premier réflexe : vérifier si l’erreur touche uniquement le sitemap ou l’ensemble du site aux mêmes horaires. Un coup d’œil aux journaux d’accès Apache confirme que non : seules les requêtes vers les URL de sitemap échouent, alors que les pages de contenu classique restent stables. Cela oriente vers un problème spécifique au coût de génération de cette ressource plutôt qu’à une saturation généralisée du serveur.
Diagnostic : la mémoire disponible sous forte charge concurrente
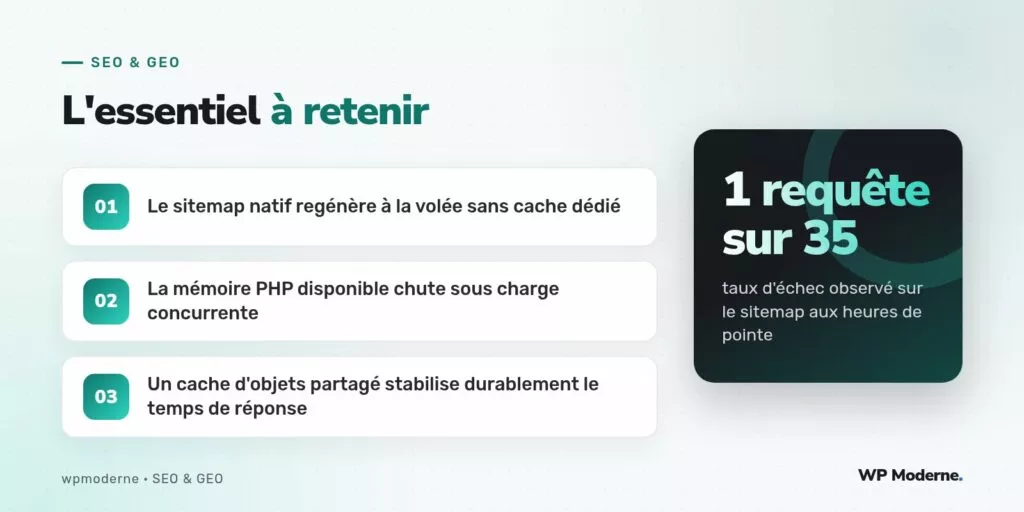
Le sitemap XML natif de WordPress, introduit avec la version 5.5, ne stocke aucun cache de sortie par défaut : chaque requête relance la construction des entrées depuis la base de données, via les classes WP_Sitemaps_Posts et consorts. Sur un catalogue de 40 000 contenus, cette génération reste raisonnable isolément, mais devient coûteuse en mémoire quand plusieurs requêtes de sitemap arrivent en même temps.
La commande suivante, exécutée en boucle sur le serveur pendant le créneau à risque, a permis d’objectiver le phénomène :
tail -F /var/log/php8.1-fpm/error.log | grep -i "memory"
Résultat : des lignes PHP Fatal error: Allowed memory size of 268435456 bytes exhausted apparaissaient précisément aux horaires signalés, et uniquement pour le worker PHP-FPM traitant une requête de sitemap. La limite de mémoire du pool, fixée à 256 Mo, suffisait en temps normal mais était dépassée lorsque plusieurs générations de sitemap tournaient en parallèle, chacune chargeant en mémoire son lot d’objets WP_Post hydratés.
Un test complémentaire avec wp shell et un chronométrage manuel de la fonction de génération a confirmé que le pic mémoire correspondait au moment où plusieurs robots (Googlebot, Bingbot, un outil d’audit tiers) crawlaient le sitemap au même instant, chacun déclenchant sa propre reconstruction complète faute de cache.
Correctif : mettre en cache la sortie du sitemap
La solution la plus robuste consiste à intercepter la sortie avant qu’elle ne déclenche une reconstruction systématique. Deux leviers complémentaires ont été retenus :
- Un cache de page dédié aux URL de sitemap, avec une durée de vie courte (15 minutes) pour rester en phase avec les publications fréquentes du site ;
- Une augmentation raisonnée de la limite mémoire du pool PHP-FPM concerné, de 256 à 384 Mo, pour absorber les pics résiduels sans faire planter le worker ;
- Un filtre pour réduire le nombre d’URL par page de sitemap, via
wp_sitemaps_max_urls, ce qui allège chaque génération individuelle.
add_filter( 'wp_sitemaps_max_urls', function() {
    return 1000;
} );
Le cache de sortie, lui, a été implémenté au niveau du serveur web plutôt que dans WordPress, pour éviter d’ajouter une dépendance supplémentaire dans le cœur applicatif. Une règle Nginx avec fastcgi_cache ciblant spécifiquement les chemins /wp-sitemap*.xml a suffi à absorber les pics de sollicitation simultanée par plusieurs robots.
Un test de charge pour valider le correctif
Avant de considérer le problème résolu, une simulation avec dix requêtes concurrentes vers le sitemap a été menée avec un outil de test de charge en ligne de commande. Sans cache, six requêtes sur dix échouaient avec une erreur 500. Avec le cache Nginx actif, les dix requêtes aboutissaient en moins de 50 ms chacune, la première seule déclenchant la génération réelle.
Prévention : surveiller la mémoire, pas seulement les erreurs 500 visibles
Cette panne illustre un piège classique : se fier uniquement aux codes de retour HTTP sans surveiller les ressources serveur sous-jacentes. Une alerte a été ajoutée sur le pool PHP-FPM pour signaler tout événement memory_limit dépassé, avant même qu’un utilisateur ou un robot ne rencontre l’erreur.
Autre bonne pratique retenue : documenter dans le wiki d’agence que tout site dépassant 10 000 contenus doit systématiquement disposer d’un cache dédié pour le sitemap, indépendamment du volume de trafic global constaté sur le reste du site. Le sitemap est en effet consulté presque exclusivement par des robots, dont le comportement de crawl simultané peut créer des pics de charge très différents de ceux générés par des visiteurs humains.
En résumé
Une erreur 500 intermittente sur un sitemap volumineux pointe presque toujours vers un problème de ressources serveur plutôt que vers un bug de code. Le réflexe à adopter : croiser les journaux d’erreurs PHP avec les horaires précis des échecs, plutôt que de chercher à reproduire le bug en environnement calme. Une fois la cause identifiée, un cache de sortie ciblé règle durablement le problème, pour un coût d’implémentation minime comparé au risque de désindexation progressive que représente un sitemap instable.