Neuf commits sur dix ne touchent qu’une poignée de fichiers, et pourtant la suite complète tourne à chaque fois dans son intégralité, sans distinction. C’est ce constat qui a donné naissance à l’analyse d’impact (« test impact analysis »), une approche qui ne rejoue que les tests réellement concernés par un changement donné, plutôt que l’intégralité d’une suite déjà longue.
Ce billet présente le principe général de cette sélection ciblée, sans entrer dans la parallélisation des tests ni dans le cache de dépendances, qui répondent à d’autres problèmes de performance.
Le principe : un graphe de dépendances entre code et tests
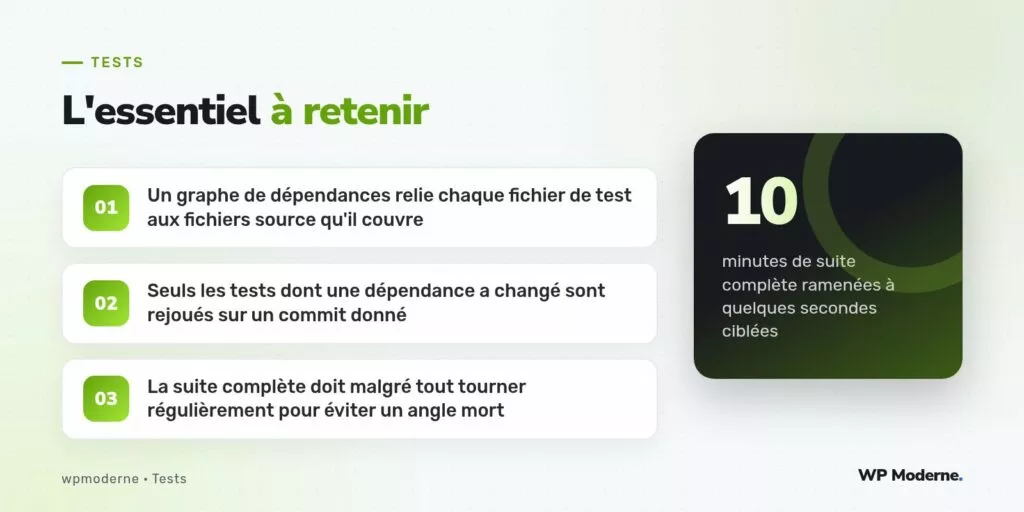
L’analyse d’impact repose sur une idée simple : construire une carte qui relie chaque test aux fichiers source dont son exécution dépend réellement. Quand un commit modifie un fichier donné, seuls les tests dont le graphe de dépendances touche ce fichier sont sélectionnés pour l’exécution.
Arborescence simplifiée de dépendances

src/
├── Fidelite/
│   ├── Calculateur.php ────────┐
│   └── Notifieur.php           │
├── Commande/                   │
│   └── Panier.php              │
tests/
├── Fidelite/
│   ├── CalculateurTest.php ◄───┘   (dépend de Calculateur.php)
│   └── NotifieurTest.php ◄─────    (dépend de Notifieur.php)
└── Commande/
    └── PanierTest.php ◄──────      (dépend de Panier.php, sans lien avec Fidelite/)
Un commit qui modifie uniquement Calculateur.php ne sélectionne alors que CalculateurTest.php, laissant de côté NotifieurTest.php et PanierTest.php, qui n’ont aucune dépendance vers le fichier modifié.
Deux façons de construire ce graphe
Analyse statique des imports
La méthode la plus simple consiste à parcourir les instructions use ou les appels de classe dans chaque fichier de test, pour en déduire les fichiers source dont il dépend directement. Cette approche est rapide à mettre en place mais rate les dépendances indirectes, par exemple un hook WordPress déclenché par un fichier tiers non importé explicitement.
Instrumentation à l’exécution
Une méthode plus précise consiste à enregistrer, pendant une exécution complète de la suite, quelles lignes de code source sont réellement traversées par chaque test, un peu à la manière d’un outil de couverture de code. Cette carte d’exécution réelle capture aussi les dépendances indirectes, mais demande une exécution initiale complète pour être construite, puis une mise à jour régulière.
Sélectionner les tests à partir du diff Git
En pratique, l’outil qui orchestre l’analyse d’impact compare la liste des fichiers modifiés par un commit (via git diff --name-only) à la carte de dépendances construite au préalable, puis dresse la liste des tests à exécuter :
git diff --name-only HEAD~1 HEAD
# src/Fidelite/Calculateur.php

# Résolution via la carte de dépendances :
# → tests/Fidelite/CalculateurTest.php sélectionné
# → tests/Commande/PanierTest.php ignoré (aucune dépendance)
La limite centrale : l’angle mort de la carte incomplète
Toute carte de dépendances, statique ou instrumentée, comporte un risque de désynchronisation avec la réalité du code : un nouveau chemin d’exécution ajouté sans que la carte ne soit régénérée peut faire passer un test à côté d’un changement qui l’affecte réellement. C’est la contrepartie de la vitesse gagnée.
- La sélection ciblée ne remplace jamais totalement une exécution complète, elle l’accélère au quotidien.
- Une exécution complète régulière (chaque nuit, ou avant chaque fusion sur la branche principale) reste nécessaire pour rattraper les angles morts de la carte.
- Un changement de configuration globale (fichier de bootstrap, dépendance Composer) doit forcer une exécution complète, quelle que soit la sélection habituelle.
Une sélection ciblée qui n’est jamais recroisée avec une exécution complète finit par masquer, plutôt que résoudre, les régressions les plus difficiles à repérer.
Quand cette approche devient rentable
En dessous de quelques minutes de suite complète, l’effort de mise en place d’une analyse d’impact dépasse souvent le gain obtenu. L’approche devient pertinente à partir du moment où l’attente d’une suite complète ralentit visiblement le rythme de commit d’une équipe, typiquement au-delà d’une dizaine de minutes par exécution.
En résumé
L’analyse d’impact ne rejoue que les tests dont la dépendance vers le code modifié est avérée, grâce à un graphe construit soit par analyse statique des imports, soit par instrumentation de l’exécution réelle. Ce gain de vitesse quotidien doit toujours rester complété par des exécutions complètes régulières, seules capables de rattraper les angles morts inévitables d’une carte de dépendances jamais parfaitement à jour.