assertEquals(['a', 'b', 'c'], $resultat) échoue alors que $resultat contient exactement les trois mêmes valeurs, dans un ordre différent. C’est la situation qui pousse beaucoup de développeurs à ajouter un sort() avant chaque comparaison, jusqu’à ce que cette habitude devienne un réflexe systématique, même quand elle n’est pas nécessaire.
Ce réflexe a un coût : il ajoute une ligne de code dont le seul but est de contourner une limitation de l’assertion utilisée, et il masque parfois un vrai problème si l’ordre du tableau retourné a, pour de bonnes raisons, une importance dans un autre contexte du test. PHPUnit propose une assertion conçue précisément pour ce cas de figure.
Ce que fait réellement assertEqualsCanonicalizing
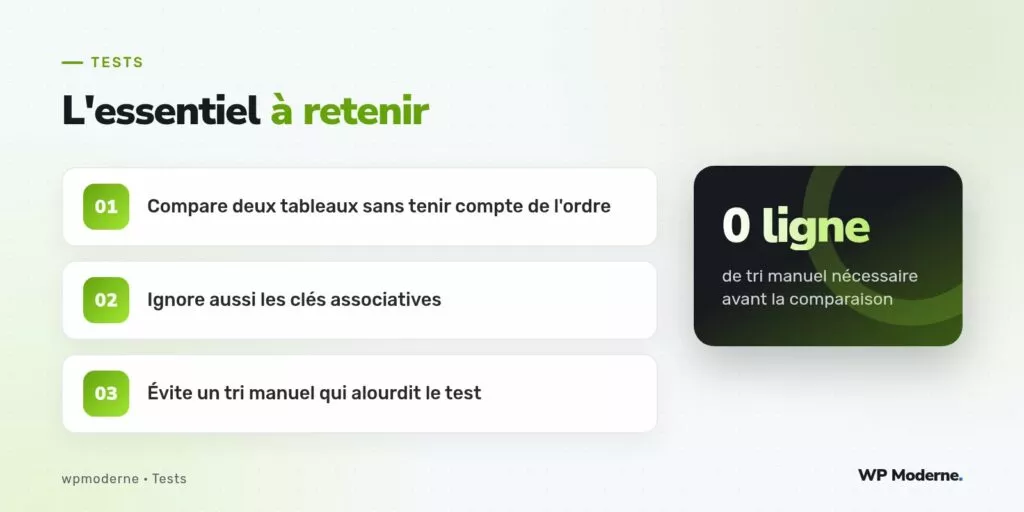
Cette méthode compare deux tableaux après les avoir « canonicalisés », c’est-à-dire ramenés à une forme normalisée qui ignore l’ordre des éléments et la nature des clés. Concrètement, deux tableaux contenant les mêmes valeurs, dans un ordre différent, ou avec des clés numériques différentes, sont considérés comme égaux.
public function test_recupere_les_bons_slugs(): void {
    $resultat = $this->service->recupere_slugs_publies();

    $this->assertEqualsCanonicalizing(
        [ 'article-a', 'article-b', 'article-c' ],
        $resultat
    );
}
Peu importe que $resultat retourne les slugs dans l’ordre ['article-c', 'article-a', 'article-b'] : le test passe, parce que l’assertion compare l’ensemble des valeurs, pas leur position.
Le problème que pose le tri manuel
Trier les deux tableaux avant de les comparer avec assertEquals classique fonctionne, mais introduit plusieurs inconvénients discrets :
- Le tri doit être appliqué aux deux côtés de la comparaison, ce qui double le risque d’oubli.
- Un tri numérique appliqué par erreur à des chaînes de caractères peut donner un ordre différent de celui attendu, faussant silencieusement le test.
- Le test devient plus long à lire : la logique de tri se mélange à l’intention réelle de la vérification.
- Si les tableaux contiennent des clés associatives porteuses de sens, un tri par valeur les fait disparaître de la comparaison.
Sur ce dernier point, assertEqualsCanonicalizing se comporte différemment d’un simple tri : elle ignore aussi les clés d’un tableau associatif, ce qu’un tri classique ne permet pas de faire proprement sans transformation préalable.
Un exemple avec des tableaux associatifs
public function test_compare_deux_configurations(): void {
    $attendu = [ 'cache' => true, 'debug' => false, 'locale' => 'fr_FR' ];
    $obtenu  = [ 'locale' => 'fr_FR', 'debug' => false, 'cache' => true ];

    $this->assertEqualsCanonicalizing( $attendu, $obtenu );
}
Ici, aucune méthode de tri classique ne suffirait sans perdre l’association clé-valeur. L’assertion gère ce cas nativement, ce qui en fait un choix naturel dès qu’un tableau retourné par une fonction n’a pas d’ordre garanti ni de raison de l’avoir.
Quand préférer assertEquals malgré tout
Cette méthode n’est pas toujours le bon choix. Si l’ordre du tableau constitue une partie du comportement testé, par exemple une liste d’articles triés par date de publication, il faut au contraire vérifier cet ordre avec assertEquals classique ou assertSame. Utiliser assertEqualsCanonicalizing dans ce cas masquerait une régression réelle : un tri cassé passerait le test sans être détecté.
Une règle simple à garder en tête : si l’ordre a un sens métier, testez-le explicitement ; s’il n’en a pas, ne le testez pas du tout, plutôt que de le neutraliser artificiellement avec un tri ajouté après coup.
Le cas des doublons
Un point mérite d’être signalé : deux tableaux avec un nombre différent de doublons d’une même valeur ne sont pas considérés comme égaux par cette assertion, contrairement à ce qu’une comparaison d’ensembles mathématiques ferait. [1, 1, 2] et [1, 2, 2] échouent la comparaison, alors qu’ils contiennent les mêmes valeurs distinctes. C’est un détail important pour des tests qui vérifient des compteurs ou des listes autorisant les répétitions.
En résumé
assertEqualsCanonicalizing résout un problème précis et fréquent : comparer deux tableaux dont l’ordre n’a pas d’importance, sans passer par une étape de tri ajoutée au test lui-même. Ce choix rend le test plus court, plus lisible et plus fidèle à l’intention réelle de la vérification, tout en évitant les pièges silencieux d’un tri appliqué à la légère sur des tableaux associatifs.