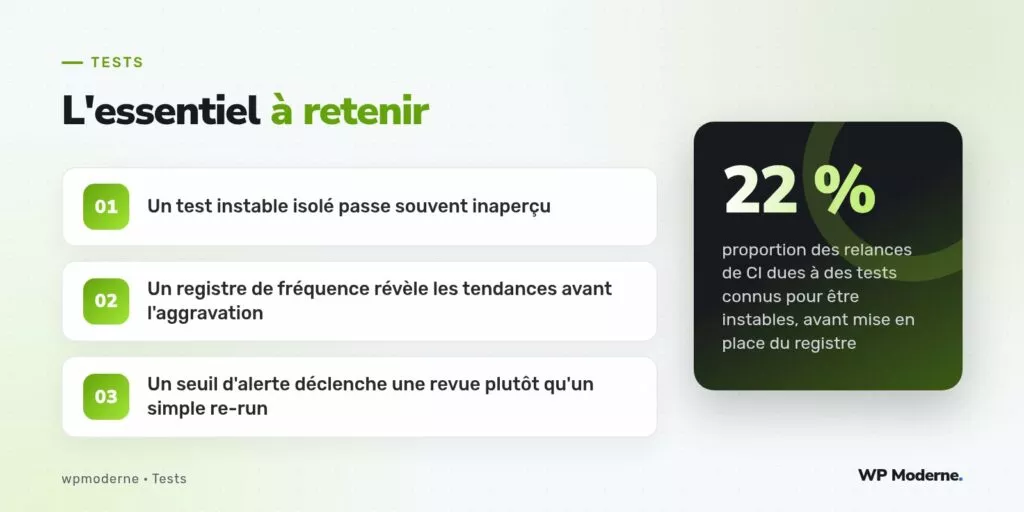
22 % des relances manuelles de pipeline d’intégration continue, sur un projet d’extension de billetterie pour des événements culturels, concernaient des tests déjà repérés comme instables par l’équipe, mais jamais formellement suivis. Chaque développeur relançait individuellement le pipeline en marmonnant que « ce test-là est connu pour foirer parfois », sans qu’aucune trace centralisée n’existe de cette connaissance informelle.
Le problème n’était pas l’absence de vigilance individuelle, mais l’absence de mémoire collective : un test qui échoue une fois sur vingt semble anecdotique test par test, mais l’accumulation de plusieurs tests dans cet état finit par rendre la suite entière peu fiable, sans qu’aucun signal ne l’annonce avant que la situation devienne critique.
Ce que l’absence de registre cachait
Sans suivi centralisé, chaque relance de pipeline efface la trace de l’échec précédent. Un test qui échouait une fois par semaine il y a six mois, et qui échoue désormais une fois par jour, ne déclenche aucune alerte tant que personne ne compare consciemment ces deux fréquences, séparées par des mois d’inattention.
Mettre en place un registre de fréquence
La solution retenue repose sur un enregistrement systématique du résultat de chaque exécution de test, stocké de façon structurée plutôt que dans les seuls journaux volatils de la CI :
Arborescence retenue :

  .ci/
    flaky-registry.json      (registre consolidé, versionné dans le dépôt)
    scripts/
      record-test-result.php (enregistre chaque résultat après exécution)
      flaky-report.php       (génère un rapport hebdomadaire de tendance)
Chaque exécution de la suite PHPUnit alimente ce registre via un script exécuté après les tests, qui enrichit un fichier JSON consolidé :
{
  "tests_wp_query_recherche_evenements": {
    "executions_30j": 142,
    "echecs_30j": 3,
    "taux_echec": 0.021,
    "tendance": "stable"
  },
  "tests_reservation_paiement_differe": {
    "executions_30j": 138,
    "echecs_30j": 19,
    "taux_echec": 0.138,
    "tendance": "en_hausse"
  }
}
Le seuil qui déclenche une revue
Un taux d’échec dépassant 5 % sur une fenêtre glissante de trente jours déclenche automatiquement la création d’un ticket de revue, assigné au responsable du module concerné, plutôt qu’une simple notification ignorée. La tendance (stable, en hausse, en baisse) compte davantage que le taux brut : un test à 8 % stable depuis des mois représente un risque connu et accepté, tandis qu’un test passé de 2 % à 8 % en deux semaines signale probablement une cause nouvelle qui mérite une investigation immédiate.
Le cas du test de réservation en paiement différé
Sur ce projet, le registre a révélé que le test de réservation avec paiement différé était passé de 2 % à 13,8 % d’échec en trois semaines, coïncidant avec l’ajout d’une file d’attente asynchrone pour le traitement des confirmations. La cause, une condition de course entre deux tâches planifiées, serait probablement restée invisible plusieurs mois de plus sans ce suivi de tendance.
Ce que le registre ne remplace pas
- Le registre signale une tendance, il n’identifie pas la cause précise d’instabilité : cette investigation reste un travail distinct, au cas par cas.
- Un test au taux d’échec stable et faible ne doit pas être ignoré indéfiniment : il reste un signal, même mineur, d’un comportement non déterministe à corriger un jour.
- Le registre doit être nettoyé des tests supprimés ou renommés, sous peine d’accumuler des entrées obsolètes qui polluent les rapports.
Un test instable qu’on ne mesure pas ne s’améliore jamais tout seul, il se contente de devenir une habitude.
En résumé
Consigner la fréquence d’échec de chaque test dans un registre versionné transforme une connaissance informelle et dispersée en signal exploitable, capable de détecter une dégradation avant qu’elle ne s’aggrave. Sur ce projet, la proportion de relances liées à des tests connus pour être instables est passée de 22 % à moins de 5 % en deux mois, une fois les tendances en hausse traitées en priorité.