200 utilisateurs simultanés, une latence moyenne de 340 millisecondes, un taux d’erreur de 0,4 % : ces chiffres, une fois le test de charge terminé, ne disent absolument rien à eux seuls. Sont-ils bons ? Mauvais ? Sans seuil défini avant le lancement du scénario, la question reste sans réponse possible, quelle que soit la précision de l’outil utilisé.
Ce billet propose une méthode pour fixer ces seuils avant d’écrire le premier scénario de charge, sans s’attacher à un outil de test de charge en particulier, chacun offrant sa propre façon de les configurer techniquement.
Partir du besoin métier, pas d’un chiffre trouvé en ligne
Un seuil de latence copié depuis un article générique n’a de sens que s’il correspond à une réalité propre au projet concerné. La question à poser d’abord : à partir de quel temps de réponse un visiteur abandonne-t-il réellement une action sur ce site précis, et quelle proportion d’échecs de commande est tolérable sur une période de forte affluence ?
Arborescence de la démarche de définition des seuils

1. Identifier le parcours critique
   └── Exemple : ajout au panier puis validation de commande
2. Fixer un seuil de latence par palier de charge
   ├── Charge nominale (50 utilisateurs) : p95 < 400 ms
   ├── Charge de pointe (200 utilisateurs) : p95 < 800 ms
   └── Charge de rupture (500 utilisateurs) : dégradation contrôlée acceptée
3. Fixer un taux d'erreur maximal toléré
   └── Exemple : moins de 1 % d'erreurs 5xx à charge de pointe
Distinguer plusieurs paliers plutôt qu’un seuil unique
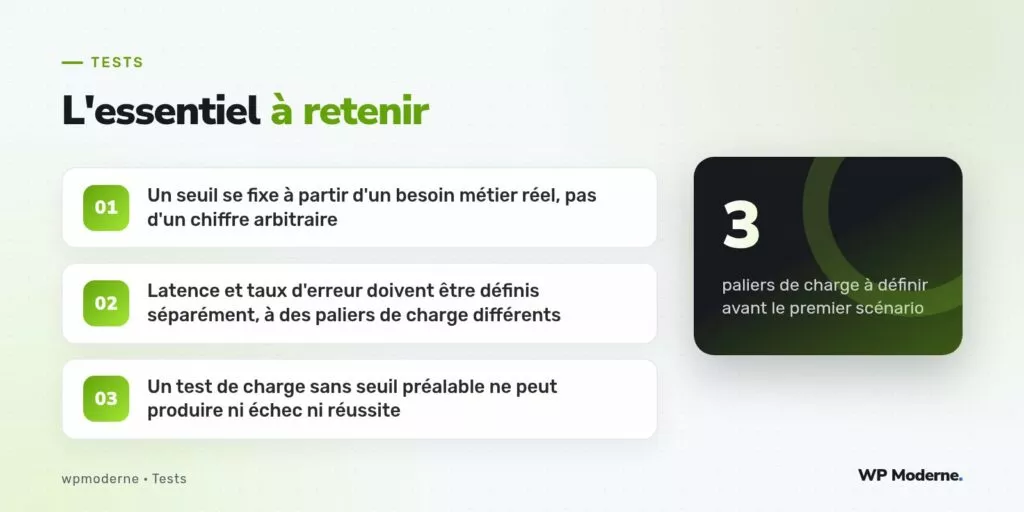
Un seul seuil de latence, appliqué à toutes les charges, mène presque toujours à un résultat trompeur : soit trop permissif à charge nominale, soit inatteignable à charge de rupture. Trois paliers distincts couvrent la plupart des besoins réels d’un site de commerce ou de contenu.
- Charge nominale : le trafic habituel, un jour ordinaire. Le seuil ici doit être strict, puisque c’est la situation la plus fréquente vécue par les visiteurs réels.
- Charge de pointe : un pic prévisible, promotion, campagne d’emailing, ouverture d’inscriptions. Le seuil peut être légèrement plus permissif, tant que le parcours critique reste fonctionnel.
- Charge de rupture : le point où le système doit dégrader proprement plutôt que de s’effondrer, par exemple en affichant une file d’attente plutôt qu’une erreur brute.
Le percentile compte plus que la moyenne
Une latence moyenne masque facilement une réalité inconfortable : une moyenne de 400 millisecondes peut cacher une majorité de requêtes à 200 millisecondes et une minorité à plus de deux secondes. Le seuil doit systématiquement porter sur un percentile élevé, le plus souvent le 95e (noté p95), pour refléter l’expérience des visiteurs les plus mal servis, pas seulement celle du cas moyen.
| Métrique | Ce qu’elle cache | Ce qu’elle révèle |
|---|---|---|
| Moyenne | Les cas extrêmes lents | Une tendance générale seulement |
| p95 | Peu de choses | L’expérience des 5 % de requêtes les plus lentes |
| Taux d’erreur | La cause de l’erreur | La fréquence du problème observé |
Documenter les seuils avant d’écrire le scénario
Une fois les paliers et les métriques choisis, il devient possible d’écrire un scénario de test de charge qui a un critère de réussite clair, plutôt qu’un simple graphique à interpréter après coup. Ce document de seuils, court, doit être validé par une personne côté métier, pas uniquement par l’équipe technique, puisqu’il traduit une tolérance business, pas une contrainte purement informatique.
Un test de charge sans seuil préalable ne peut jamais échouer ni réussir : il ne produit qu’un graphique, dont l’interprétation devient arbitraire une fois le test terminé.
Réviser les seuils après chaque campagne réelle
Les seuils fixés avant le premier test de charge ne sont pas gravés dans le marbre. Après chaque campagne de forte affluence réelle, comparer le comportement observé en production aux seuils définis permet de les affiner, souvent à la baisse une fois la marge réelle du système mieux connue.
En résumé
Fixer des seuils de latence par percentile et de taux d’erreur, pour plusieurs paliers de charge distincts, avant d’écrire le premier scénario de test, transforme un test de charge en outil de décision plutôt qu’en simple production de graphiques. Cette préparation, courte à rédiger, évite le débat stérile qui suit souvent un test de charge sans critère de réussite préalable.