Un test snapshot compare un rendu capturé à une référence enregistrée, et signale toute différence, aussi minime soit-elle. C’est précisément cette exhaustivité qui devient un problème quand le rendu capturé englobe trop d’éléments : une classe CSS générée dynamiquement, un attribut d’accessibilité ajouté par une bibliothèque tierce, ou un identifiant unique suffisent à faire échouer le test sans qu’aucun bug réel ne soit en cause.
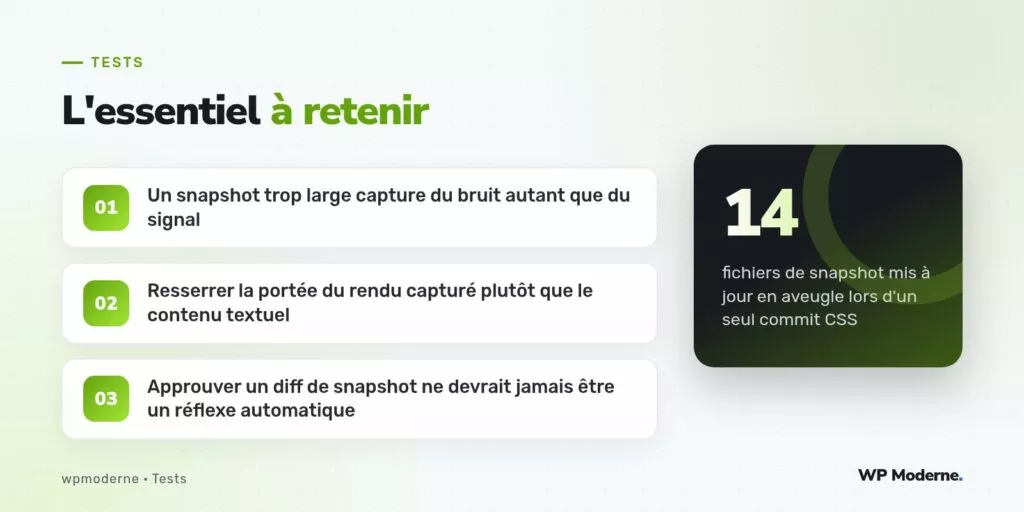
Sur un projet de thème de blocs Gutenberg pour un réseau de librairies indépendantes, quatorze fichiers de snapshot ont échoué simultanément après un simple changement de nom de classe CSS sans impact fonctionnel. La réaction immédiate de l’équipe a été de régénérer tous les snapshots en une commande, sans relecture individuelle — le symptôme exact de l’antipattern qui allait être diagnostiqué.
Ce qu’on observe
Le test snapshot type ressemblait à ceci, capturant le rendu HTML complet d’un bloc :
test('rend le bloc citation avec attribution', () => {
  const { container } = render(<BlocCitation texte="…" auteur="…" /></bloccitation>);
  expect(container).toMatchSnapshot();
});
Le fichier de snapshot généré contenait l’intégralité du HTML rendu, y compris des classes utilitaires ajoutées automatiquement par l’outillage de build, des attributs data-wp-* injectés par le cœur de Gutenberg, et des identifiants générés à la volée. Chacun de ces éléments changeait pour des raisons totalement étrangères au comportement du bloc citation lui-même.
Pourquoi c’est un problème
Un snapshot qui échoue trop souvent pour de mauvaises raisons produit deux effets délétères, qui se renforcent l’un l’autre :
- La perte de confiance : après plusieurs faux positifs, l’équipe commence à approuver les diffs de snapshot sans les lire attentivement, ce qui annule la valeur du test.
- Le bruit qui masque le signal : le jour où un vrai changement de comportement se glisse dans le diff, personne ne le remarque, noyé parmi les changements anodins habituels.
Le quatorzième fichier de snapshot mis à jour sans relecture, sur ce projet, contenait justement une régression réelle : l’attribut cite de la balise blockquote avait disparu suite à une modification du composant, cassant silencieusement l’accessibilité du bloc citation pour les lecteurs d’écran.
Ce qu’on fait à la place
Le correctif ne consiste pas à abandonner les tests snapshot, mais à resserrer précisément ce qu’ils capturent. Trois changements ont été appliqués :
- Utiliser un sérialiseur personnalisé qui retire les attributs générés dynamiquement (identifiants, classes utilitaires) avant la comparaison, plutôt que de les inclure puis de les ignorer visuellement à chaque relecture.
- Capturer uniquement le sous-arbre pertinent du DOM (
container.querySelector('blockquote')) plutôt que le conteneur complet, pour que le snapshot ne réagisse qu’aux changements du bloc lui-même. - Compléter certains snapshots trop généraux par des assertions ciblées (
expect(citation).toHaveAttribute('cite', urlSource)) sur les propriétés jugées critiques, en plus du snapshot.
expect.addSnapshotSerializer({
  test: (val) => typeof val === 'string',
  print: (val) => val.replace(/data-wp-[a-z-]+="[^"]*"/g, '').replace(/id="[a-z0-9-]+"/g, ''),
});
Une règle simple pour la suite
L’équipe a adopté une règle de revue : tout diff de snapshot doit être lu ligne par ligne avant approbation, sans exception, même sur un commit qui semble purement esthétique. Si un développeur ne comprend pas pourquoi une ligne a changé, le snapshot n’est pas mis à jour tant que la cause n’est pas identifiée.
Un snapshot qui échoue et qu’on approuve sans le lire n’est plus un test, c’est une formalité.
Ce qu’on ne recommande pas
La génération initiale des snapshots, la première capture de référence, sort du périmètre de ce constat : le problème ne porte pas sur la création, mais sur l’entretien d’un snapshot devenu trop large avec le temps. Un snapshot resserré dès le départ évite en grande partie ce piège, mais un projet existant doit souvent revenir sur des snapshots déjà en place pour les corriger.
En résumé
Un snapshot trop bavard n’est pas un test plus complet, c’est un test moins fiable, parce qu’il finit par être approuvé par réflexe plutôt que par vérification. Depuis le resserrement de la portée sur ce projet, le nombre de snapshots modifiés par commit a nettement baissé, et chaque diff restant est désormais effectivement porteur d’un changement de comportement réel.