Un habitant qui demande à l’assistant d’accueil d’une mairie « comment renouveler ma carte d’identité » attend une réponse fiable. Le même habitant qui demande, par curiosité ou par erreur, « quel est le meilleur restaurant du centre-ville » ne doit surtout pas recevoir une réponse inventée avec le même aplomb. C’est cette deuxième situation, bien plus difficile à garantir, qui a structuré la suite de tests du projet.
Le chatbot, intégré à un site WordPress de collectivité, répond aux questions administratives courantes à partir d’un corpus documentaire contrôlé : horaires, démarches, formulaires. Le risque n’est pas qu’il se trompe sur une question dans son périmètre, mais qu’il réponde avec assurance à une question qui n’en fait pas partie.
Construire un corpus de questions hors périmètre
La suite de tests contient 27 questions volontairement hors sujet, classées en trois catégories : questions administratives d’une autre collectivité, questions commerciales sans lien avec le service public, et questions ambiguës qui ressemblent à une démarche mais n’en sont pas une, comme « pouvez-vous me réserver une salle de mariage » sur un site qui ne gère pas cette prestation.
$hors_perimetre = array(
    "Quel est le meilleur restaurant du centre-ville ?",
    "Pouvez-vous réserver une salle de mariage ?",
    "Quels sont les horaires de la mairie de la ville voisine ?",
);

foreach ( $hors_perimetre as $question ) {
    $reponse = $assistant->repondre( $question );
    $this->assertTrue( $reponse->est_un_refus_poli() );
}
Chaque test vérifie non pas l’absence de réponse, mais la présence d’un refus explicite qui redirige vers un canal humain, un standard téléphonique ou un formulaire de contact générique.
Fixer un seuil de confiance exploitable
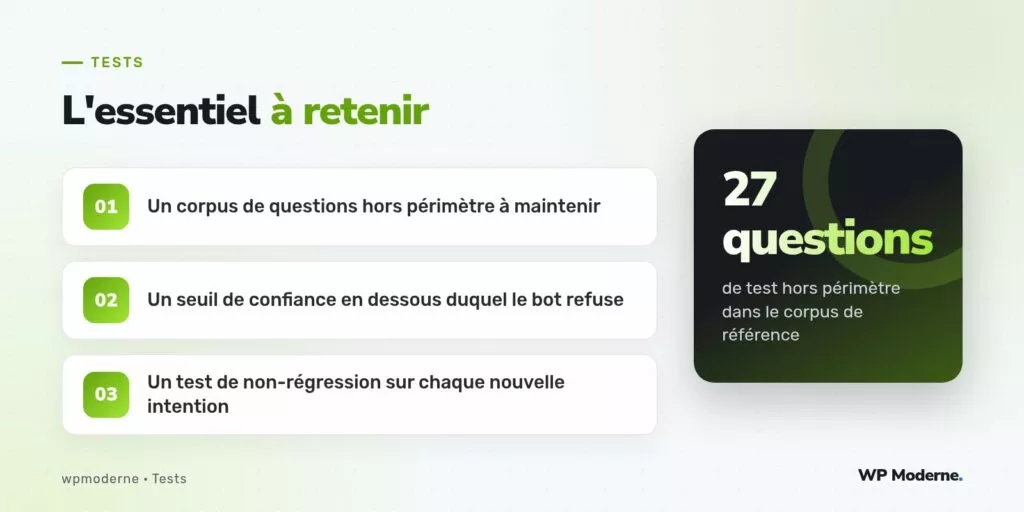
Le moteur sous-jacent retourne un score de pertinence pour chaque réponse générée à partir du corpus documentaire. En dessous d’un seuil fixé à 0,62 après plusieurs itérations empiriques, la réponse est automatiquement remplacée par le message de redirection, quel que soit le contenu généré.
- Score supérieur à 0,62 : réponse du corpus affichée telle quelle
- Score entre 0,45 et 0,62 : réponse affichée avec une invitation à vérifier auprès d’un agent
- Score inférieur à 0,45 : refus poli et redirection systématique
Éviter le sur-ajustement au corpus de test
Un risque identifié tôt : ajuster le seuil jusqu’à ce que les 27 questions de test passent, sans vérifier que les vraies questions administratives continuent d’obtenir une réponse utile. Un deuxième corpus, celui des questions dans le périmètre, sert de garde-fou symétrique : il vérifie qu’aucune question légitime ne tombe sous le seuil de refus par excès de prudence.
Automatiser la non-régression à chaque ajout de contenu
Chaque ajout d’une nouvelle démarche au corpus documentaire déclenche l’exécution complète des deux suites, périmètre et hors périmètre. Un ajout mal formulé peut élargir accidentellement la zone de confiance du moteur et faire répondre le bot à une question qu’il aurait dû refuser auparavant.
Un assistant qui refuse correctement une question hors sujet inspire davantage confiance qu’un assistant qui répond toujours, même à côté de la plaque.
Ce que cette suite ne couvre pas
Le choix du modèle de génération sous-jacent, ses coûts d’inférence ou sa latence, relève d’une décision technique distincte, documentée séparément par l’équipe infrastructure. Cette suite de tests ne s’intéresse qu’au comportement observable du chatbot face à l’utilisateur final, indépendamment du moteur qui produit les réponses.
En résumé
Sur un projet grand public porté par une collectivité, la robustesse perçue ne vient pas de la richesse des réponses mais de la fiabilité des refus. Vingt-sept questions hors périmètre, un seuil de confiance calibré et un corpus symétrique de contrôle ont permis de livrer un assistant qui ne prétend jamais savoir ce qu’il ignore.