Faut-il vraiment tout couvrir par des tests avant la moindre mise en ligne, ou existe-t-il une façon raisonnable d’apprendre en production sans mettre l’ensemble des utilisateurs en risque ? Sur un projet de moteur de recherche interne pour un site d’annonces immobilières entre particuliers, une nouvelle fonctionnalité de suggestion de recherche par proximité géographique posait une question de ce type : la couvrir intégralement par des tests automatisés aurait retardé la mise en ligne de plusieurs semaines, sans garantie que les tests anticipent tous les comportements réels des utilisateurs.
L’approche retenue a combiné un feature flag et une observation ciblée en production, une méthode qui ne remplace pas les tests mais réduit le risque d’une exposition brutale à 100 % des utilisateurs dès le premier jour.
Définition : ce qu’un feature flag change dans la stratégie de test
Un feature flag encapsule une fonctionnalité derrière une condition activable indépendamment du déploiement du code. La fonctionnalité peut être déployée en production, inactive pour la majorité des utilisateurs, puis activée progressivement pour un sous-ensemble croissant, sans nouveau déploiement à chaque étape.
Fonctionnement interne de la progression retenue
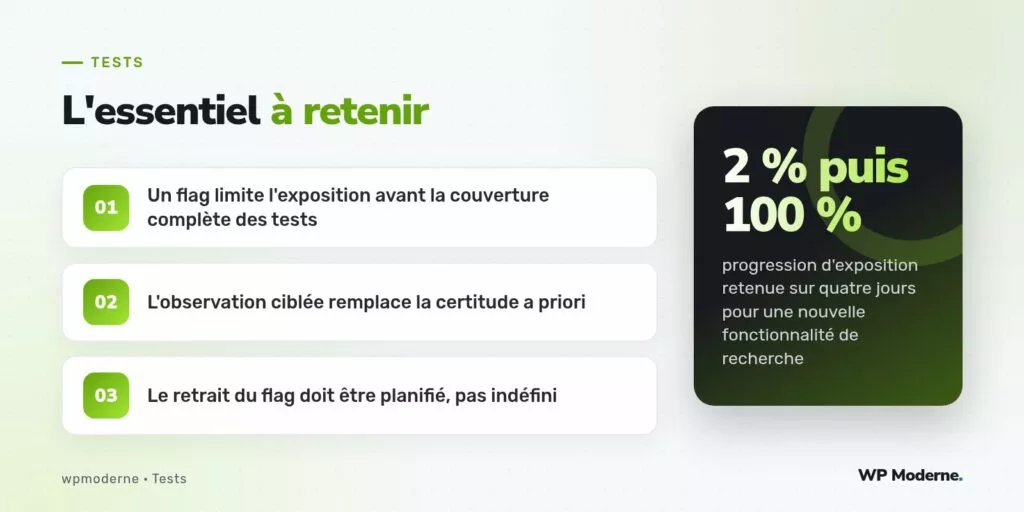
Sur ce projet, la progression d’exposition s’est étalée sur quatre jours, avec un seuil d’observation à chaque palier avant de passer au suivant :
Jour 1 : 2 % des recherches exposées à la nouvelle suggestion
Jour 2 : 10 %, si aucune anomalie relevée sur les métriques suivies
Jour 3 : 50 %, si le taux de clic sur les suggestions reste stable
Jour 4 : 100 %, retrait du flag et du code conditionnel associé
À chaque palier, trois métriques étaient suivies de près : le taux d’erreur serveur sur l’endpoint de suggestion, le temps de réponse moyen, et le taux de clic effectif sur une suggestion proposée, comparé au comportement de recherche classique sans suggestion.
Ce que l’observation a révélé au deuxième palier
Au passage à 10 % d’exposition, le temps de réponse moyen de l’endpoint de suggestion a doublé, sans qu’aucune erreur ne remonte. L’observation ciblée a permis de repérer ce ralentissement avant qu’il ne touche la moitié des utilisateurs, et d’identifier une requête de géolocalisation non indexée correctement en base, invisible dans l’environnement de test qui ne contenait qu’un faible volume d’annonces.
Ce que cette méthode ne dispense pas de faire
- Les tests automatisés couvrant le comportement fonctionnel de base restent indispensables avant même la première exposition à 2 % : le flag limite l’exposition à un risque déjà partiellement réduit, il ne remplace pas une vérification initiale minimale.
- Le choix de l’outil de feature flag (service dédié ou implémentation maison simple) est une décision distincte, qui dépend de la taille de l’équipe et du nombre de fonctionnalités gérées ainsi simultanément.
- Un flag qui reste actif indéfiniment, « au cas où », devient une dette technique : sa suppression doit être planifiée dès sa création, avec une date ou un critère de retrait explicite.
Les pièges de cette approche
Le principal piège consiste à confondre l’absence d’erreur observée avec l’absence de bug réel : un flag limité à 2 % des utilisateurs peut très bien ne jamais exposer un cas limite rare, qui n’apparaîtra qu’après le passage à 100 %. L’observation ciblée réduit le risque, elle ne l’élimine pas, ce qui justifie de maintenir une vigilance active même après le dernier palier.
Un feature flag n’évite pas d’avoir à bien tester une fonctionnalité, il évite de faire porter tout le risque du premier jour à l’ensemble des utilisateurs.
En résumé
Combiner un feature flag à une observation ciblée sur quelques métriques précises a permis, sur ce projet, de détecter un problème de performance avant qu’il n’affecte la majorité des utilisateurs, tout en évitant plusieurs semaines de retard qu’une couverture de test exhaustive préalable aurait exigées. La fonctionnalité a atteint 100 % d’exposition au quatrième jour, sans incident après le correctif appliqué au deuxième palier.