1) [chromium] › parcours-panier.spec.ts:42:5 › ajoute un produit et affiche le total › Timed out 5000ms waiting for locator('.cart-total') — ce message, isolé, ne dit rien d’utile. Il apparaît une fois sur trente exécutions, jamais deux fois de suite sur la même machine, et disparaît quand on relance le test seul en local.
Sur un projet de boutique en ligne pour une torréfaction artisanale, ce test de parcours panier échouait sporadiquement en intégration continue depuis plusieurs semaines. Les logs de la console ne montraient rien d’anormal, et personne n’arrivait à reproduire l’échec à la demande.
Symptôme : un échec qui ne se laisse pas reproduire
Le comportement typique d’un test instable capturé par un simple journal texte est de fournir une trace d’appel Playwright et un message de timeout, sans contexte visuel ni chronologie précise des événements réseau. On sait que le sélecteur .cart-total n’est pas apparu à temps, mais pas pourquoi : DOM absent, requête réseau lente, ou animation qui décale l’affichage ?
Relancer le test localement, en boucle, pour espérer reproduire l’échec, coûte du temps sans garantie de résultat — d’autant que la cause est souvent liée à une condition de timing propre à l’environnement CI, plus chargé que le poste local.
Diagnostic : activer et exploiter la trace
Playwright peut enregistrer une trace complète de l’exécution — captures d’écran, arbre DOM, requêtes réseau, journal des actions — sans ralentir significativement les passages qui réussissent, en la limitant aux tentatives en échec :
// playwright.config.ts
export default defineConfig({
  use: {
    trace: 'on-first-retry',
  },
  retries: 1,
});
Avec cette configuration, dès qu’un test échoue une première fois, Playwright relance automatiquement une tentative avec la trace activée, et conserve le fichier trace.zip associé uniquement pour cette tentative. En CI, ce fichier est ensuite archivé comme artefact de build.
L’ouverture se fait ensuite en local, avec la trace téléchargée :
npx playwright show-trace trace.zip
Ce que révèle la trace
Le trace viewer affiche une chronologie action par action, avec pour chacune un instantané du DOM avant et après, ainsi que les requêtes réseau qui se sont déclenchées pendant la fenêtre d’attente. Sur ce test de panier, la lecture image par image a montré que l’appel à l’endpoint REST /wp-json/wc/store/v1/cart mettait occasionnellement plus de quatre secondes à répondre, sans lien avec le navigateur ou le sélecteur : la lenteur venait du calcul de frais de port recalculé à chaque ajout au panier, dépendant d’un service de zones de livraison chargé de façon paresseuse.
Correctif : cibler la vraie attente
Le test attendait un élément d’interface alors que la véritable dépendance était une requête réseau encore en vol. Le correctif a consisté à attendre explicitement la réponse de cette requête avant de vérifier l’affichage :
const reponsePanier = page.waitForResponse(
  (reponse) => reponse.url().includes('/wc/store/v1/cart') && reponse.status() === 200
);
await page.getByRole('button', { name: 'Ajouter au panier' }).click();
await reponsePanier;
await expect(page.locator('.cart-total')).toBeVisible();
Ce changement rend le test dépendant d’un événement observable plutôt que d’un délai implicite, ce qui élimine la variabilité liée à la charge du service de calcul de frais de port.
Prévention : garder l’habitude de la trace
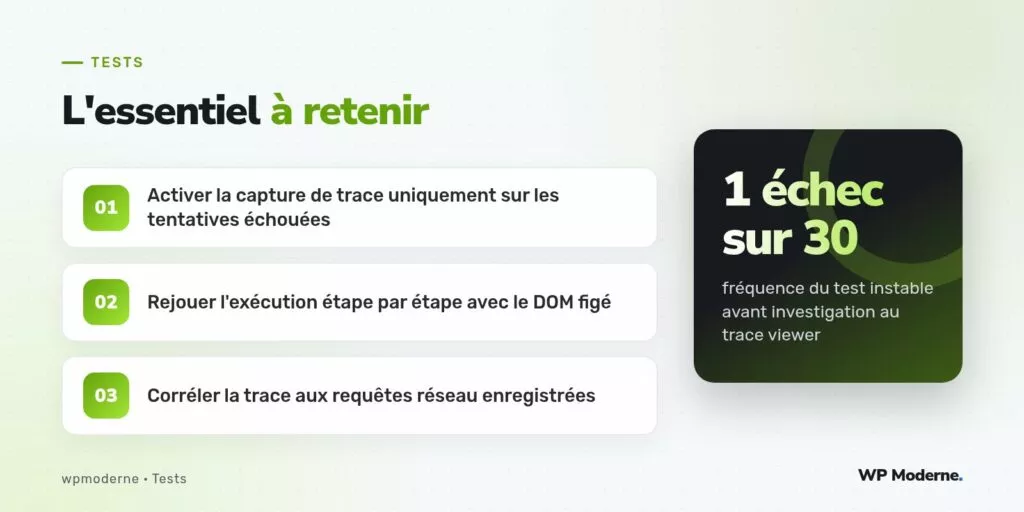
Une fois la cause identifiée, l’équipe a conservé trace: 'on-first-retry' en configuration permanente plutôt que de la retirer après coup. Le coût de stockage des traces échouées est négligeable comparé au temps perdu à deviner une cause sans preuve.
- Archiver systématiquement les traces des tentatives échouées en CI, avec une durée de rétention de quelques semaines.
- Documenter dans le fichier de test lui-même la requête réseau critique attendue, pour qu’un futur lecteur comprenne pourquoi ce
waitForResponseexiste. - Revoir périodiquement les tests qui déclenchent le plus de tentatives en échec, signe qu’une dépendance réseau instable mérite d’être isolée plus largement.
Un test instable n’a pas besoin d’un délai plus long, il a besoin d’attendre la bonne chose.
Notre verdict
Le trace viewer transforme un échec fantôme en preuve exploitable : il ne devine rien, il montre l’état réel du DOM et du réseau au moment précis de l’échec. Sur ce projet, la fréquence d’échec du test de panier est passée d’une fois sur trente à zéro sur les deux mois suivants, sans qu’aucun autre test n’ait eu besoin d’un délai artificiellement allongé.