Un import de plusieurs centaines de références produit affiche, à la fin, une liste de catégories deux fois plus longue que prévu. Chaque catégorie semble légitime, avec un nom presque identique à une autre déjà présente — une majuscule en plus, un espace en trop, un accent qui manque — mais suffisamment différent pour que WordPress les considère comme deux termes distincts.
La cause se trouve presque toujours dans le script d’import lui-même : un appel direct à wp_insert_term(), sans vérification préalable que le terme visé existe déjà sous une forme équivalente dans la taxonomie ciblée.
Ce que wp_insert_term() vérifie, et ce qu’il ne vérifie pas
wp_insert_term() refuse bien de créer deux fois un terme dont le nom et le slug correspondent exactement à un terme déjà existant dans la même taxonomie : dans ce cas précis, elle renvoie une erreur WP_Error avec le code term_exists. Le piège se situe ailleurs : dès que le nom transmis diffère, même légèrement, du nom déjà enregistré, WordPress génère un nouveau slug distinct et crée un nouveau terme, sans aucun avertissement ni erreur.
// Terme déjà existant : « Chaussures de running »

wp_insert_term( 'chaussures de running', 'categorie_produit' );
// Crée un second terme, slug différent, aucune erreur renvoyée.

wp_insert_term( 'Chaussures de Running', 'categorie_produit' );
// Idem : un troisième terme distinct apparaît.
Sur un import automatisé qui traite une source de données externe — un flux fournisseur, un export d’un autre système — ces variations de casse ou de ponctuation sont fréquentes, et chacune génère silencieusement un nouveau terme.
Vérifier avec term_exists() avant d’insérer
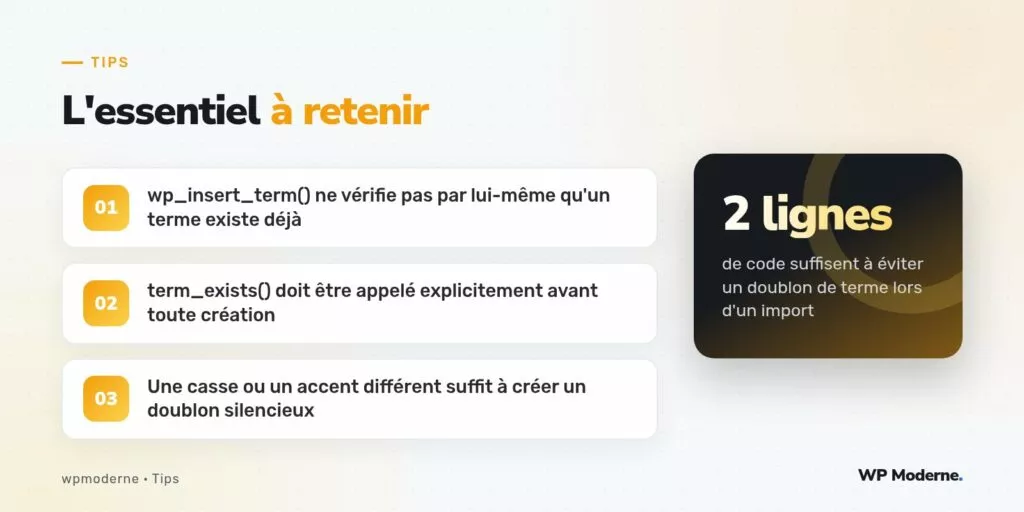
La fonction term_exists() est justement conçue pour ce contrôle préalable. Elle accepte le nom ou le slug recherché, ainsi que la taxonomie concernée, et renvoie l’identifiant du terme s’il existe déjà, ou 0/null dans le cas contraire :
function importer_categorie( $nom, $taxonomie ) {
    $existant = term_exists( $nom, $taxonomie );

    if ( $existant ) {
        return (int) $existant['term_id'];
    }

    $resultat = wp_insert_term( $nom, $taxonomie );

    if ( is_wp_error( $resultat ) ) {
        error_log( 'Erreur import catégorie : ' . $resultat->get_error_message() );
        return 0;
    }

    return (int) $resultat['term_id'];
}
Ce contrôle en deux étapes — vérifier, puis insérer seulement si nécessaire — reste la méthode la plus fiable pour un script d’import destiné à tourner plusieurs fois sur la même source, sans multiplier les doublons à chaque exécution.
Le cas des variations de casse pures
term_exists() compare le nom fourni de façon insensible à la casse pour les correspondances exactes sur le nom, mais les variations d’espaces superflus ou de ponctuation ne sont pas systématiquement normalisées avant la comparaison. Sur une source de données peu fiable, mieux vaut donc normaliser soi-même la chaîne avant l’appel : retirer les espaces en début et fin avec trim(), réduire les espaces multiples, uniformiser les apostrophes typographiques.
- Appliquer un
trim()systématique sur le nom avant toute comparaison. - Uniformiser la casse pour l’affichage, sans pour autant modifier le slug d’un terme déjà en production.
- Journaliser chaque création de terme pendant un import, pour repérer visuellement d’éventuelles quasi-doublons a posteriori.
Repérer les doublons déjà créés
Sur un site où le mal est déjà fait, une requête via get_terms() triée par nom permet de repérer visuellement les termes aux libellés très proches. Un script WP-CLI parcourant la liste et calculant une distance de similarité entre les noms consécutifs aide à cibler rapidement les candidats à une fusion manuelle, plutôt que de parcourir la liste entière à l’œil sur une taxonomie qui compte plusieurs centaines d’entrées.
Sur tout script d’import destiné à être rejoué plusieurs fois, systématiser
term_exists()avant chaquewp_insert_term()coûte deux lignes de code et évite des heures de nettoyage de taxonomie a posteriori.
En résumé
Le doublon silencieux ne vient pas d’un bug de WordPress, mais d’une hypothèse implicite trop optimiste : croire que wp_insert_term() détecte seul les termes équivalents. Ce n’est vrai que pour une correspondance exacte. Le réflexe à garder pour tout import : vérifier explicitement avec term_exists(), normaliser la chaîne en amont, et ne créer qu’en dernier recours.