34 articles publiés entre deux heures et six heures du matin, un lundi de mars, sans qu’aucun humain n’ait relu la moindre ligne. Le scénario d’automatisation no-code, construit pour générer et publier automatiquement du contenu à partir d’une liste de mots-clés, faisait exactement ce pour quoi il avait été configuré — publier directement, sans étape intermédiaire de validation. L’outil no-code utilisé pour construire ce scénario n’est pas discuté ici.
Le réveil a été brutal : plusieurs articles contenaient des répétitions de phrases entières, deux traitaient un sujet quasiment identique sous des titres différents, et un article confondait deux produits du catalogue dans sa description.
Comment ce scénario avait été construit
Le scénario, pensé initialement comme un test limité à quelques articles par semaine, reliait trois étapes : lecture d’une liste de mots-clés dans un tableur, génération d’un article complet via un appel à un LLM, puis publication directe dans WordPress via l’API REST avec le statut publish défini dès la création. Aucune étape de relecture n’avait été prévue, faute d’avoir anticipé que le volume traité grimperait aussi vite une fois la liste de mots-clés élargie sans concertation avec l’équipe éditoriale.
Le déclencheur de la nuit en question : un import massif de nouveaux mots-clés dans le tableur source, réalisé par une personne qui ignorait que ce tableur alimentait directement le scénario de publication automatique.
Ce que révèle cet incident
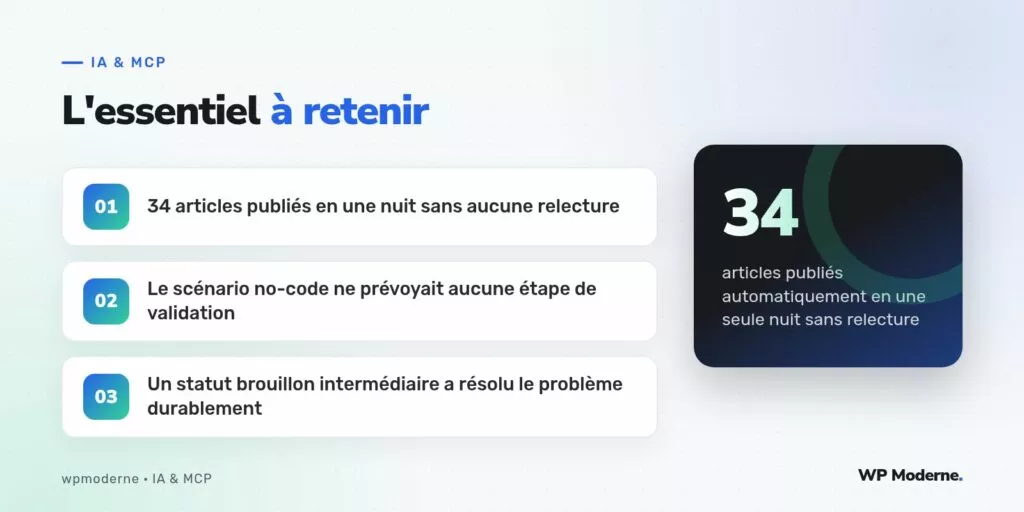
Le problème ne venait pas de la qualité intrinsèque du contenu généré, globalement correcte prise article par article, mais de l’absence totale de filtre entre la génération et la publication effective. Un scénario no-code, aussi simple à construire soit-il, hérite des mêmes risques qu’un développement sur mesure dès lors qu’il touche à la publication de contenu public : l’absence de validation humaine reste une décision de conception, pas un détail technique secondaire.
- Aucun contrôle de doublon entre les articles générés dans une même exécution du scénario.
- Aucune vérification de cohérence entre le contenu généré et le catalogue produit réel.
- Aucune limite de volume par exécution, permettant à un import massif de déclencher une publication en cascade.
Le correctif appliqué
Le statut de publication défini par le scénario a été changé de publish à draft, transformant chaque génération en brouillon en attente de validation plutôt qu’en publication directe. Une notification est désormais envoyée à l’équipe éditoriale à chaque lot de brouillons créés, avec un lien direct vers la liste à valider dans l’administration WordPress.
{
  "etape": "publication_wordpress",
  "statut_defini": "draft",
  "notification": "email_equipe_editoriale",
  "limite_par_execution": 5
}
Une limite de cinq articles générés par exécution a également été ajoutée, empêchant qu’un import massif de mots-clés ne déclenche à nouveau un volume incontrôlé en une seule nuit.
Le tri des 34 articles publiés par erreur
Sur les 34 articles concernés, 21 ont été jugés publiables après une relecture rapide, 9 ont nécessité une réécriture partielle, et 4 ont été supprimés purement et simplement, jugés trop proches d’articles déjà existants sur le site pour être conservés sous une autre forme.
Un scénario d’automatisation qui fonctionne bien à petite échelle ne dit rien de son comportement à grande échelle : c’est précisément l’absence de relecture humaine qui transforme un incident mineur en incident visible publiquement.
En résumé
Un automatisme no-code reliant génération IA et publication directe reste dangereux tant qu’aucune étape de validation humaine ne s’intercale entre les deux. Le statut brouillon, combiné à une limite de volume par exécution, a suffi ici à transformer un scénario risqué en un gain de temps réel pour l’équipe éditoriale, sans reproduire l’incident de cette nuit de mars.
L’incident a aussi eu un effet plus durable sur la façon dont l’équipe conçoit désormais ses scénarios d’automatisation : toute nouvelle chaîne touchant à la publication de contenu public passe systématiquement par une revue collective avant mise en production, y compris pour un scénario qui semble anodin ou limité à un usage interne restreint au moment de sa création.