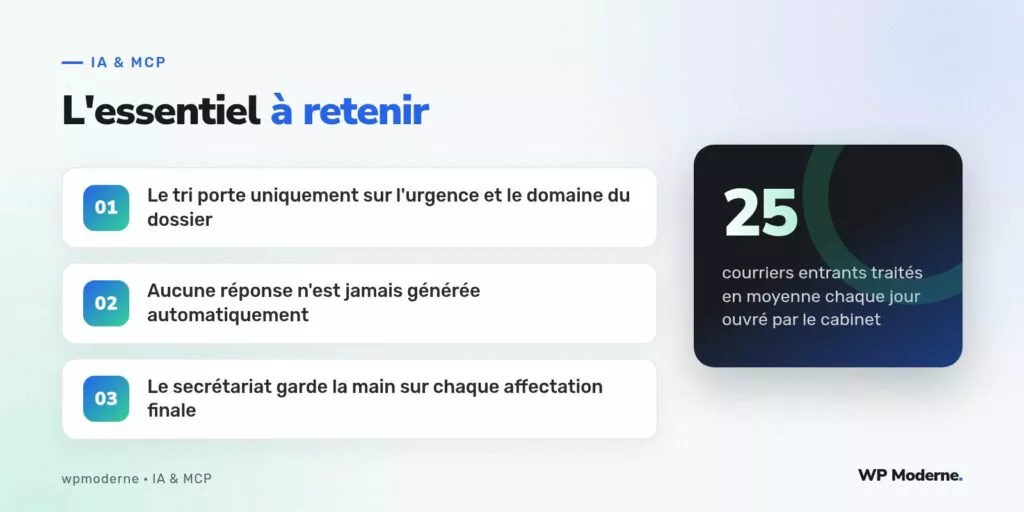
Vingt-cinq courriers entrants en moyenne chaque jour ouvré, entre convocations, courriers de confrères, relances de clients et pièces à verser aux dossiers en cours : le secrétariat d’un cabinet d’avocats de taille moyenne passait auparavant une bonne partie de sa matinée à simplement trier ce flux avant de pouvoir l’affecter aux bons dossiers et aux bons avocats.
Fin 2023, le cabinet a testé un modèle de langage pour assister cette étape de tri, avec un périmètre volontairement restreint : classer, jamais répondre.
Ce que le modèle fait réellement
Chaque courrier scanné à l’arrivée est transmis, sous forme de texte extrait, à un modèle de langage chargé d’identifier deux informations : le domaine juridique concerné (droit du travail, droit des affaires, droit de la famille, selon la spécialisation des avocats du cabinet) et un niveau d’urgence apparent, en particulier la présence d’une date limite de réponse mentionnée dans le courrier. Ces deux informations remontent dans un tableau de bord consulté par le secrétariat, qui affecte ensuite manuellement chaque courrier au bon avocat.
À aucun moment le modèle ne rédige de réponse, ni même une ébauche : sa sortie se limite à ces deux étiquettes de classification, jamais à du texte destiné à être envoyé tel quel à un tiers.
Pourquoi cette limite a été fixée aussi strictement
Le bâtonnier consulté en amont du projet a insisté sur un point : toute réponse à un courrier engageant la position du cabinet dans un dossier doit rester rédigée et validée par l’avocat en charge, sans exception ni raccourci, quelle que soit la simplicité apparente du courrier reçu. Cette position a été intégrée telle quelle dans le cadrage du projet, avant même le choix technique du fournisseur d’API.
Les erreurs de classification observées
- Un courrier mentionnant une date de convocation dans un paragraphe secondaire, plutôt qu’en objet, a parfois été classé comme non urgent alors qu’il aurait dû l’être, le modèle accordant davantage de poids aux formulations d’objet qu’au corps du texte.
- La distinction entre droit du travail et droit des affaires reste imparfaite sur des courriers concernant un litige entre une entreprise et un ancien salarié, les deux domaines se chevauchant sur ce type de dossier.
- Un courrier rédigé dans un style ancien ou avec des tournures juridiques rares a occasionnellement été mal catégorisé, le modèle s’appuyant sur des formulations plus courantes pour reconnaître un domaine.
Le garde-fou mis en place face à ces erreurs
Le secrétariat vérifie systématiquement, chaque matin, l’ensemble des courriers classés « non urgent » de la veille, précisément parce que c’est sur cette catégorie que le risque d’erreur silencieuse est le plus élevé : un courrier urgent mal classé passerait inaperçu plus longtemps qu’un courrier non urgent classé à tort comme urgent.
Le principe retenu par le cabinet : mieux vaut un tri qui sur-classe l’urgence par excès de prudence, quitte à générer un peu de vérification supplémentaire, qu’un tri qui manque une échéance réelle.
En résumé
Ce cas illustre un usage prudent et circonscrit de l’intelligence artificielle dans un cabinet d’avocats : améliorer un tri administratif chronophage, sans jamais toucher à la substance du conseil juridique ni à la rédaction d’une réponse engageant la responsabilité du cabinet. Le gain de temps sur le secrétariat reste réel, mais repose entièrement sur une vérification humaine quotidienne assumée comme non négociable.
Le cabinet a par ailleurs pris soin de vérifier, avant tout déploiement, les conditions de confidentialité proposées par le fournisseur d’API retenu, en particulier sur la conservation éventuelle des textes transmis à des fins d’amélioration du modèle. Cette vérification a conduit à écarter un premier fournisseur dont les conditions par défaut ne convenaient pas au secret professionnel attaché à la profession, au profit d’une offre proposant une option contractuelle de non-conservation des données transmises.
Ce point, souvent négligé dans l’enthousiasme du premier test technique, s’est révélé décisif dans le choix final du prestataire, bien davantage que la simple performance de classification observée lors des essais préliminaires.



