0,0005 $ le token en entrée, 0,0015 $ en sortie : ces chiffres, affichés sur la page tarifaire d’un fournisseur de LLM, ne disent presque rien du coût réel d’un projet tant que la longueur moyenne des réponses générées n’est pas connue. Ce comparatif chiffre le coût réel de génération de 10 000 fiches produit textiles selon quatre fournisseurs, sans évaluer la qualité rédactionnelle obtenue, sujet traité par ailleurs.
Le prompt utilisé pour ce test comprenait une description structurée de chaque produit (matière, coupe, entretien) en entrée, pour une fiche de vente complète en sortie, avec une consigne de longueur cible fixée à 180 mots.
Le protocole de mesure
Chaque fournisseur a traité le même échantillon de 300 fiches avant extrapolation sur les 10 000 fiches du catalogue complet. Le coût réel a été calculé en tenant compte à la fois du nombre de tokens en entrée (prompt système, description produit, exemples de style) et du nombre de tokens réellement générés en sortie, mesurés directement via les métadonnées renvoyées par chaque API.
Un cinquième fournisseur, initialement pressenti, a été écarté du test faute de documentation suffisante sur son tarif par token à la date de ce comparatif.
Les tarifs affichés contre le coût réel
| Fournisseur | Tarif entrée / sortie (pour 1 000 tokens) | Tokens moyens générés / fiche | Coût réel / 10 000 fiches |
|---|---|---|---|
| Fournisseur A | 0,0005 $ / 0,0015 $ | 310 | 52 € |
| Fournisseur B | 0,0003 $ / 0,0009 $ | 410 | 44 € |
| Fournisseur C | 0,0008 $ / 0,0024 $ | 245 | 68 € |
| Fournisseur D | 0,0002 $ / 0,0006 $ | 520 | 36 € |
Le fournisseur C, le plus cher au token affiché, générait les réponses les plus courtes en moyenne, réduisant l’écart final avec les autres fournisseurs. À l’inverse, le fournisseur D, le moins cher au token, produisait des réponses nettement plus longues que la consigne de 180 mots ne le demandait, rognant une partie de son avantage tarifaire.
Le poids sous-estimé du prompt d’entrée
Sur ce test, le prompt système et les exemples de style inclus dans chaque requête représentaient à eux seuls environ 340 tokens par appel, soit davantage que certaines réponses générées par le fournisseur C. Réduire ce prompt de 30 %, en supprimant deux exemples de style jugés redondants, a permis une économie mesurable sur l’ensemble des 10 000 fiches, tous fournisseurs confondus.
- Un prompt d’entrée trop long grève le coût final autant qu’un tarif par token élevé.
- La longueur réelle des réponses générées varie fortement d’un fournisseur à l’autre, à consigne identique.
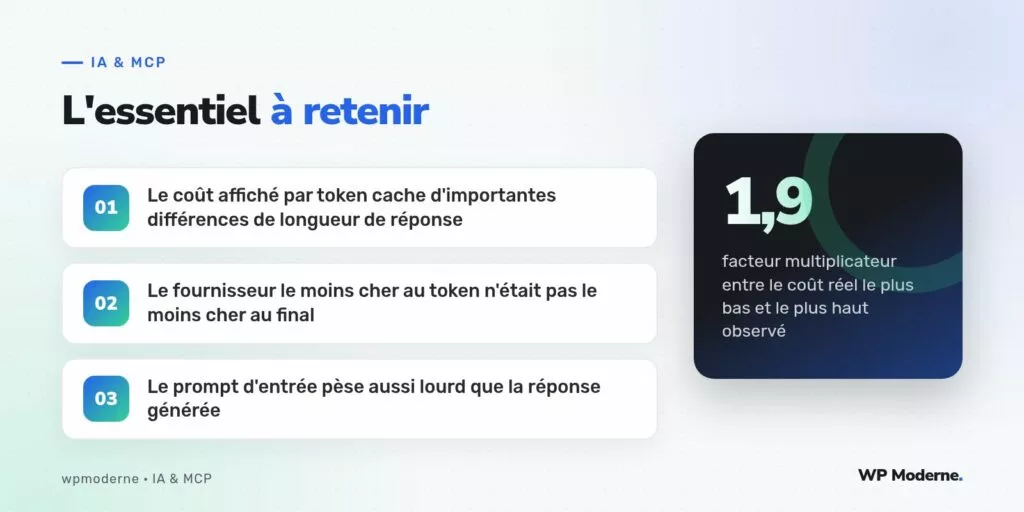
- Le facteur de coût réel observé entre le fournisseur le moins cher et le plus cher atteint 1,9, loin de l’écart affiché sur les grilles tarifaires brutes.
Ce que ce comparatif ne mesure pas
Aucune évaluation de la qualité rédactionnelle des fiches générées n’a été intégrée à ce comparatif, volontairement circonscrit au seul aspect financier. Un fournisseur moins coûteux produisant des fiches nécessitant davantage de retouches humaines pourrait voir son avantage économique s’annuler une fois ce coût de relecture intégré — un calcul qui dépasse le cadre de cet article.
Le tarif affiché par token ne renseigne jamais sur le coût réel d’un projet : seule une mesure sur un échantillon représentatif, prompt et réponse compris, permet de comparer honnêtement plusieurs fournisseurs entre eux.
Notre verdict
Sur ce projet, le fournisseur D s’est révélé le moins cher au global malgré des réponses plus longues que prévu, grâce à un tarif au token suffisamment bas pour absorber ce surcoût. Aucune conclusion générale ne peut cependant être tirée pour un autre type de contenu : la longueur moyenne des réponses générées reste le facteur qui pèse le plus lourd dans le calcul final, bien avant le tarif affiché.
Reste un dernier point à surveiller avant de généraliser un choix de fournisseur sur la seule base de ce type de comparatif : les grilles tarifaires évoluent régulièrement, parfois à la baisse à mesure que la concurrence s’intensifie entre fournisseurs de LLM. Un comparatif figé six mois plus tôt peut donc devenir obsolète sans que rien ne le signale, d’où l’intérêt de relancer ce protocole de mesure sur un petit échantillon avant chaque nouveau projet de volume important, plutôt que de se fier indéfiniment à un choix ancien.