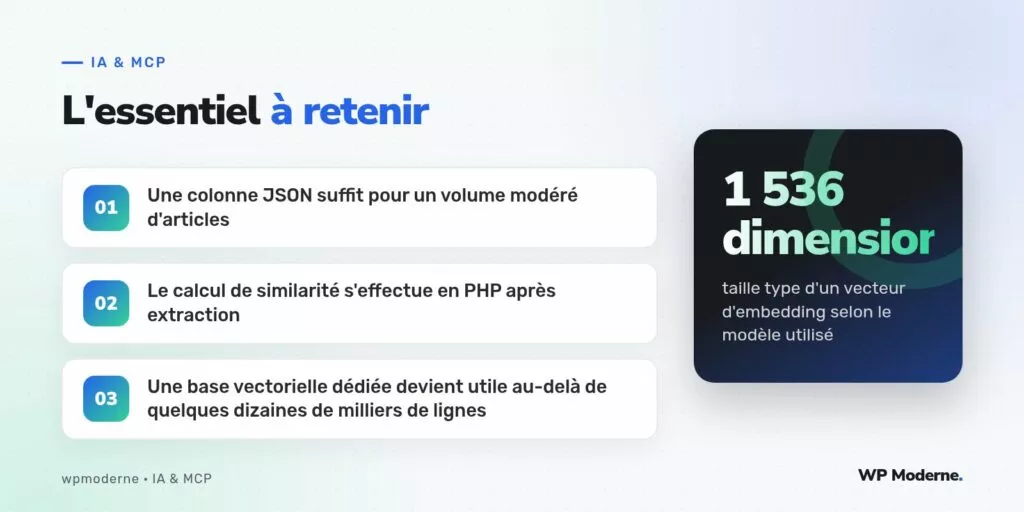
Combien d’articles un site doit-il publier avant qu’une base vectorielle dédiée devienne vraiment nécessaire pour une recherche par similarité ? Sur la majorité des sites éditoriaux, la réponse est simple : bien plus que ce que contient le site. Une colonne JSON dans une table MySQL classique, gérée depuis le type JSON disponible depuis MySQL 5.7, couvre largement les besoins d’un catalogue de quelques milliers d’articles.
L’approche décrite ici évite d’introduire une dépendance externe pour un besoin qui reste, à cette échelle, parfaitement soluble avec les outils déjà présents sur l’hébergement.
Étape 1 : créer la table de stockage des vecteurs
Une table dédiée, distincte des tables cœur de WordPress, stocke un vecteur par article, associé à son identifiant :
CREATE TABLE wp_embeddings_articles (
    post_id BIGINT UNSIGNED NOT NULL PRIMARY KEY,
    vecteur JSON NOT NULL,
    genere_le DATETIME NOT NULL,
    FOREIGN KEY (post_id) REFERENCES wp_posts(ID) ON DELETE CASCADE
);
Étape 2 : générer et enregistrer le vecteur
Le vecteur, obtenu auprès d’une API d’embedding, s’enregistre tel quel sous forme de tableau JSON, sans transformation intermédiaire :
global $wpdb;

$vecteur = appeler_api_embedding( $texte_article );

$wpdb->query( $wpdb->prepare(
    "INSERT INTO wp_embeddings_articles (post_id, vecteur, genere_le)
     VALUES (%d, %s, NOW())
     ON DUPLICATE KEY UPDATE vecteur = VALUES(vecteur), genere_le = NOW()",
    $post_id,
    wp_json_encode( $vecteur )
) );
Étape 3 : charger les vecteurs candidats
MySQL ne propose pas nativement, sans extension spécifique, de fonction de distance entre vecteurs. La comparaison s’effectue donc en deux temps : une extraction en PHP des vecteurs à comparer, suivie d’un calcul de similarité côté application :
$resultats = $wpdb->get_results(
    "SELECT post_id, vecteur FROM wp_embeddings_articles",
    ARRAY_A
);
Limiter le volume chargé
Charger l’ensemble de la table à chaque recherche devient coûteux au-delà de quelques milliers de lignes. Une première restriction, par catégorie ou par date de publication récente, réduit le nombre de vecteurs comparés sans dégrader significativement la pertinence des résultats sur un site éditorial classique.
Étape 4 : calculer la similarité cosinus en PHP
function similarite_cosinus( array $a, array $b ): float {
    $produit_scalaire = 0.0;
    $norme_a = 0.0;
    $norme_b = 0.0;

    foreach ( $a as $i => $valeur ) {
        $produit_scalaire += $valeur * $b[ $i ];
        $norme_a += $valeur ** 2;
        $norme_b += $b[ $i ] ** 2;
    }

    return $produit_scalaire / ( sqrt( $norme_a ) * sqrt( $norme_b ) );
}
Étape 5 : trier et retourner les articles les plus proches
$vecteur_cible = json_decode( $vecteur_article_courant, true );
$scores = array();

foreach ( $resultats as $ligne ) {
    if ( (int) $ligne['post_id'] === $post_id_courant ) {
        continue;
    }
    $vecteur_compare = json_decode( $ligne['vecteur'], true );
    $scores[ $ligne['post_id'] ] = similarite_cosinus( $vecteur_cible, $vecteur_compare );
}

arsort( $scores );
$articles_proches = array_slice( array_keys( $scores ), 0, 5, true );
Quand cette approche atteint ses limites
Le calcul en PHP, exécuté sur l’ensemble des vecteurs candidats à chaque recherche, croît linéairement avec le nombre d’articles. Au-delà de quelques dizaines de milliers de lignes, le temps de calcul devient perceptible côté utilisateur, et une base vectorielle dédiée, capable d’indexer les vecteurs pour une recherche approchée, prend alors tout son sens.
- Quelques centaines à quelques milliers d’articles : colonne JSON largement suffisante
- Quelques dizaines de milliers : envisager une mise en cache des résultats de comparaison fréquents
- Au-delà : une base vectorielle dédiée devient pertinente
Introduire une base vectorielle dédiée avant d’en avoir réellement besoin ajoute une dépendance et une charge opérationnelle sans bénéfice mesurable à petite échelle.
Notre verdict
Pour un catalogue d’articles de taille modeste, une colonne JSON associée à un calcul de similarité en PHP offre une solution simple à mettre en œuvre, sans dépendance externe. La bascule vers une base vectorielle dédiée mérite d’être posée en fonction du volume réel constaté, plutôt qu’anticipée sans données concrètes.