Comparer trois modèles sur une même tâche technique demande un protocole strict pour que la comparaison ait un sens : à l’équipe produit de l’éditeur fictif de tarification Paymento, il a fallu écrire un unique prompt, décrivant une politique tarifaire en langage naturel, et le soumettre sans modification à GPT-4o, à Claude 3.5 Sonnet et à Gemini, pour observer lequel produisait la structure de règles la plus directement exploitable par une intégration Stripe.
La politique testée combinait plusieurs conditions courantes : une remise de 15 % pour les paiements annuels plutôt que mensuels, un tarif dégressif au-delà de cinquante sièges, et une exclusion des remises cumulées avec un code promotionnel actif. La sortie attendue prenait la forme d’un objet JSON décrivant des règles conditionnelles, destiné à être ensuite relu par un développeur avant toute intégration réelle côté paiement.
Ce que chaque modèle a produit
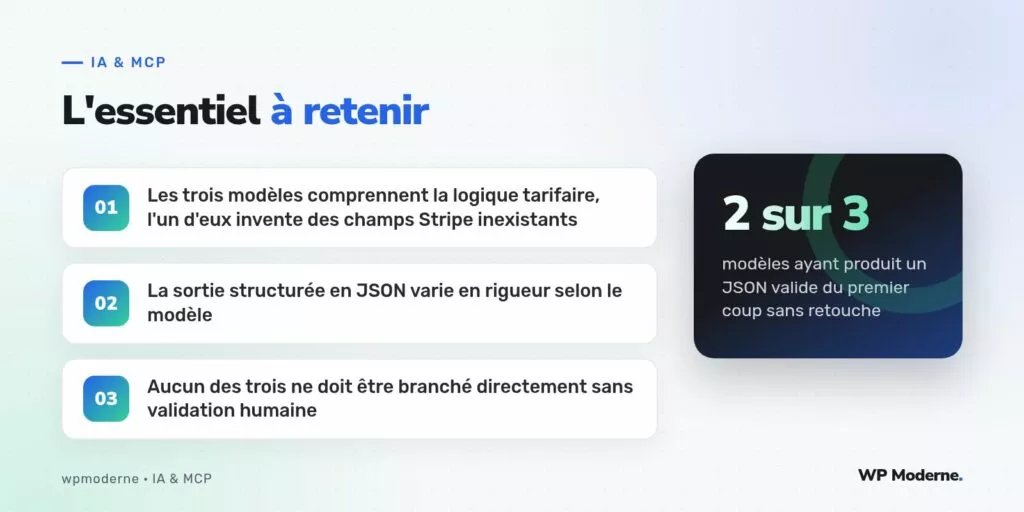
GPT-4o a livré une structure JSON valide dès la première tentative, avec des noms de champs cohérents entre eux, mais une erreur de fond notable : il a inventé un champ discount_stack_limit qui ne correspond à aucun objet de l’API Stripe, en présentant cette invention avec la même assurance que le reste de la réponse. Un développeur pressé, qui copierait cette sortie sans vérification, risquerait d’intégrer un champ fantôme dans sa logique métier.
Claude 3.5 Sonnet a produit une sortie légèrement plus verbeuse, mais sans aucun champ inventé : il s’est limité aux concepts que Stripe expose réellement (Price, Coupon, tiered pricing), en signalant explicitement dans un commentaire que la logique d’exclusion des remises cumulées devrait être implémentée côté application, Stripe ne gérant pas nativement ce cas par une simple règle déclarative.
Gemini, enfin, a bien identifié la logique tarifaire générale mais a produit un JSON syntaxiquement invalide à la première tentative, avec une virgule surnuméraire qui a nécessité une correction manuelle avant de pouvoir être exploité par un script de validation automatique.
Sorties structurées : un point commun à surveiller
Les trois modèles savent produire du JSON quand on le leur demande, mais avec des degrés de rigueur différents face à une consigne de format strict. Demander explicitement un schéma de sortie, plutôt qu’un exemple informel dans le prompt, a nettement amélioré la validité syntaxique des réponses de Gemini lors d’un second essai, ce qui suggère que l’écart initial tenait autant à la formulation du prompt qu’aux capacités intrinsèques du modèle.
{
  "rule": "annual_discount",
  "condition": { "billing_interval": "year" },
  "discount_percent": 15
}
Tableau comparatif
| Critère | GPT-4o | Claude 3.5 Sonnet | Gemini |
|---|---|---|---|
| JSON valide au premier essai | Oui | Oui | Non |
| Champ Stripe inventé | Oui | Non | Non |
| Signale les limites de Stripe | Non | Oui | Partiellement |
| Longueur de la réponse | Concise | Détaillée | Concise |
Ce que ce test ne mesure pas
- La rapidité de réponse de chaque modèle, non chronométrée dans ce protocole informel.
- Le comportement sur des politiques tarifaires bien plus complexes, à plus de dix conditions imbriquées.
- La mise en œuvre effective de ces règles côté intégration Stripe, qui sort du périmètre de ce comparatif.
Un modèle qui invente un champ d’API avec assurance est plus dangereux qu’un modèle qui produit un JSON syntaxiquement fautif : la seconde erreur se voit immédiatement, la première peut passer une revue de code inattentive.
Verdict
Sur cet exercice précis, Claude 3.5 Sonnet a produit la sortie la plus directement fiable, sans invention de champ et avec un signalement explicite des limites de Stripe sur le cas d’exclusion de remises. GPT-4o reste très capable mais demande une vigilance particulière sur l’exactitude des noms de champs qu’il propose. Gemini, une fois la contrainte de format renforcée dans le prompt, rattrape l’essentiel de son retard initial sur la validité syntaxique.
En résumé
Aucun des trois modèles ne doit être branché directement à une logique de paiement sans qu’un développeur ne relise et ne valide chaque règle générée : ce comparatif porte sur la qualité de la proposition, pas sur son exécution. Sur ce critère précis, la fiabilité factuelle l’a emporté sur la rapidité ou la concision de la réponse.